Agents de contenu multilingues : localiser pour des comptes en hébreu, en arabe et en anglais, sans traduire
Contenu multilingue avec des agents IA : localisation ou traduction, pièges de l'hébreu et de l'arabe de droite à gauche, légendes par compte.
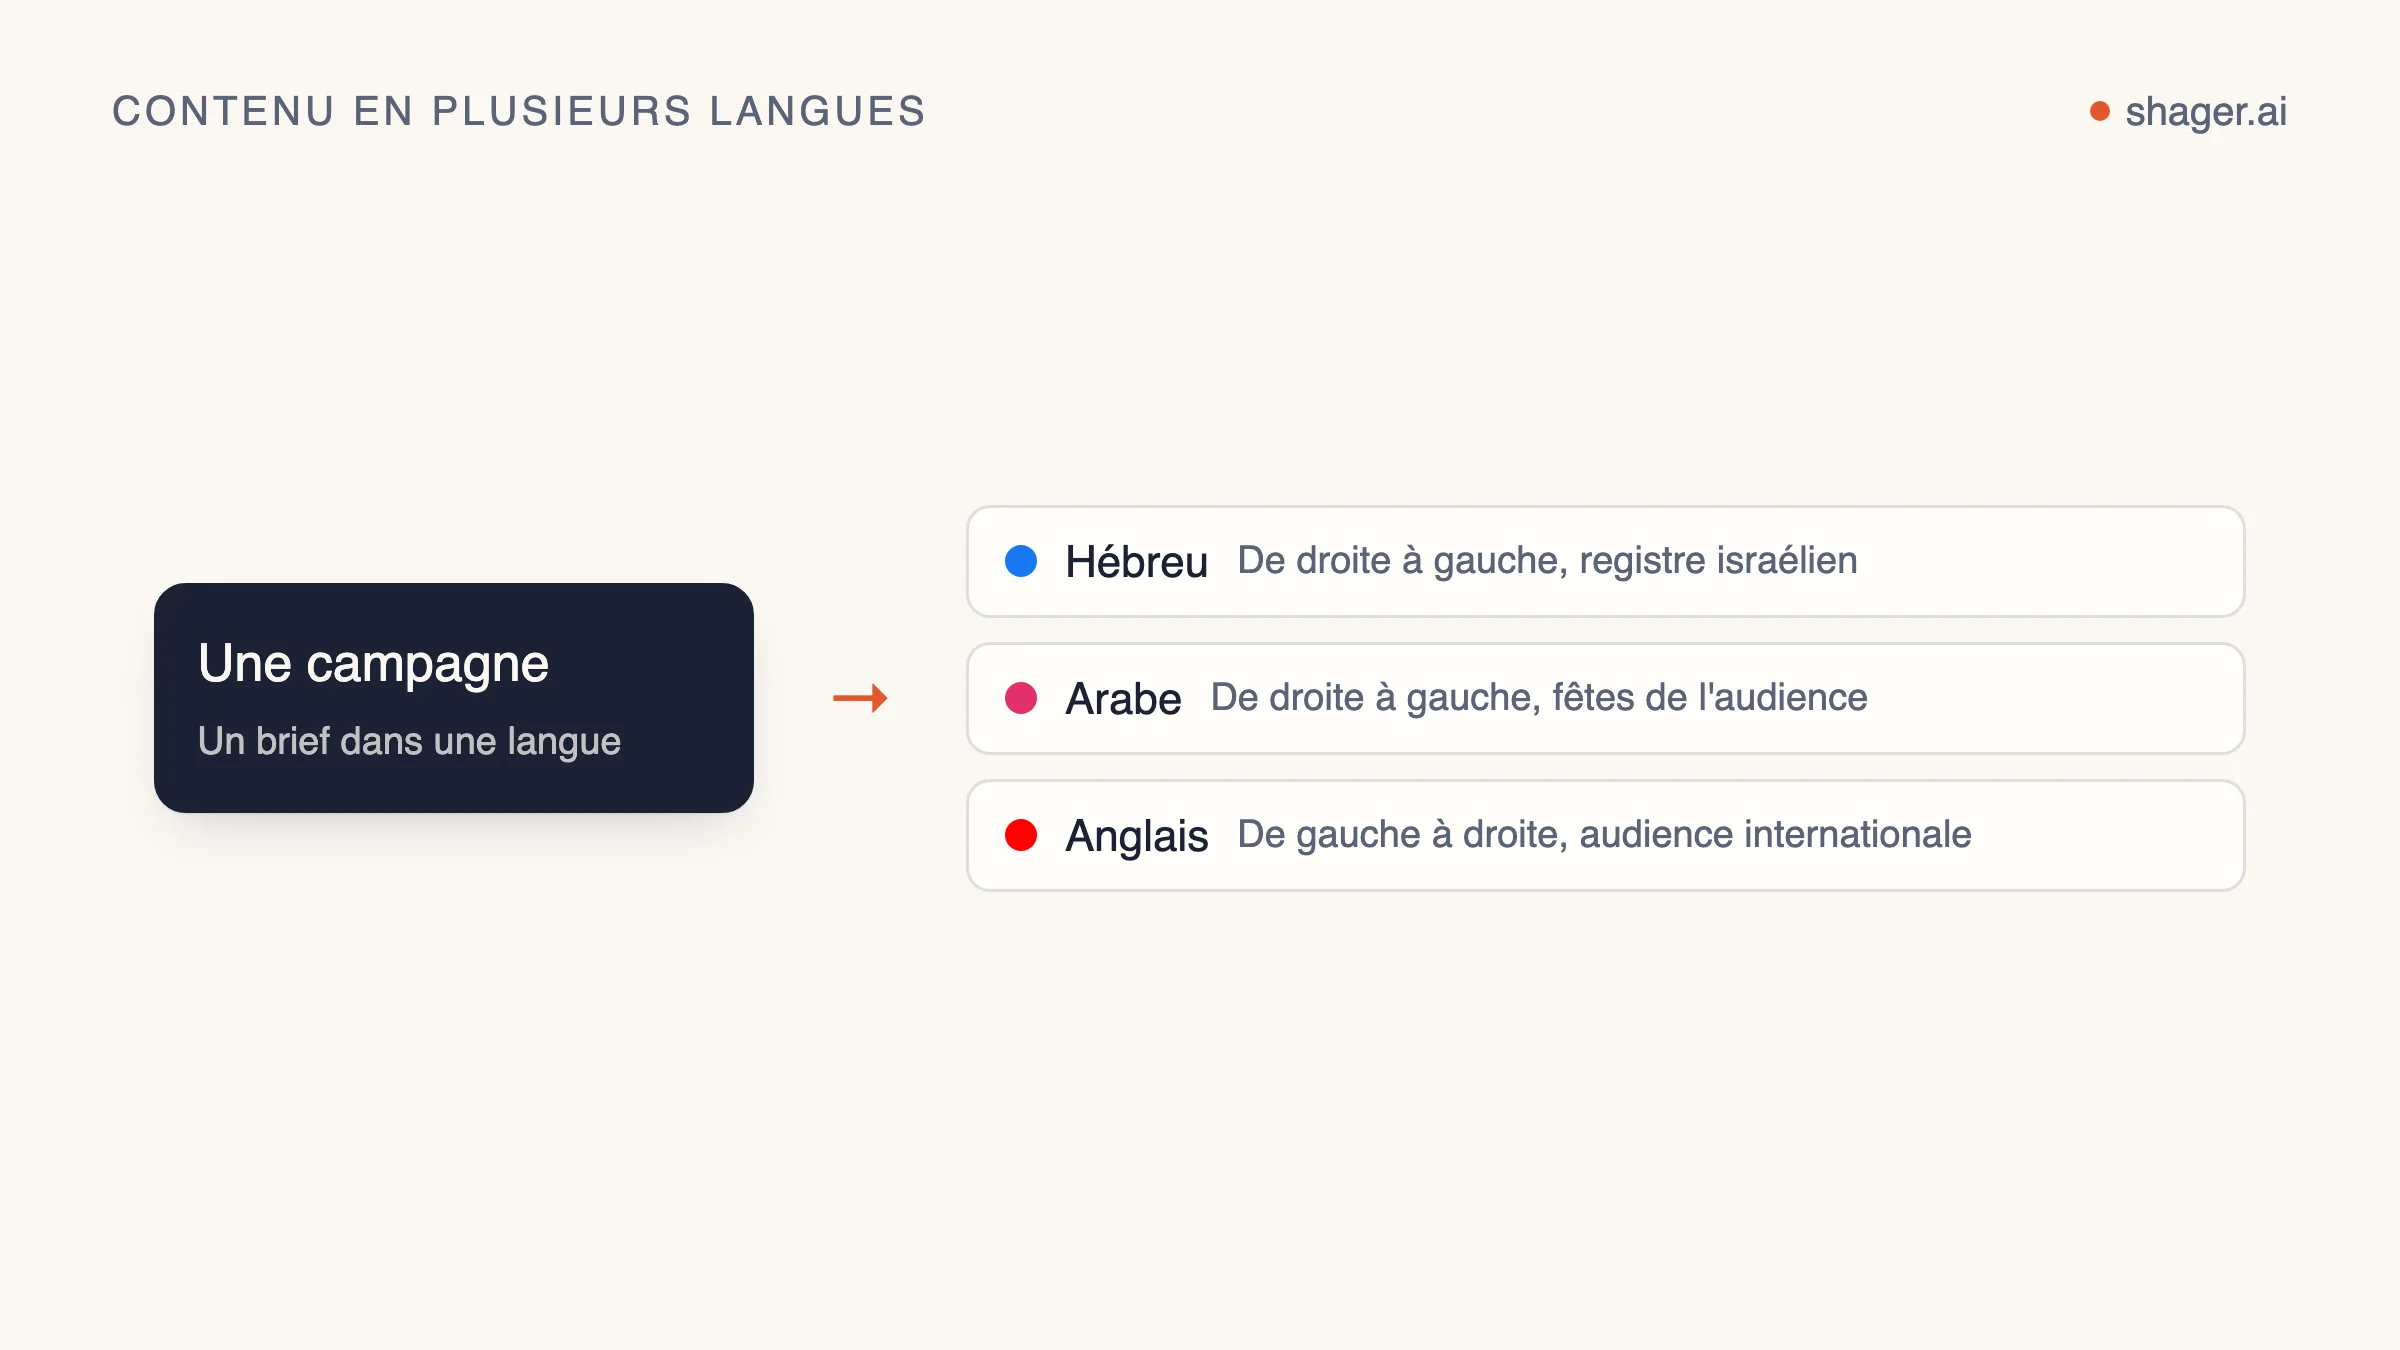
Un agent de contenu multilingue doit rédiger directement la légende de chaque compte dans la langue de ce compte, à partir d'un brief commun, et non traduire ligne à ligne un texte de référence en anglais. Dans Shager, cela veut dire une publication par groupe de langue, avec une légende distincte par compte dans per_channel, ainsi qu'un lien, un titre YouTube et un premier commentaire propres à chaque langue. Pour les langues qui s'écrivent de droite à gauche, comme l'hébreu et l'arabe, l'agent doit en plus gérer les textes à double sens d'écriture : chiffres, URL, noms de marque et hashtags au milieu de phrases RTL.
C'est sur cette seconde partie que la plupart des diffusions multilingues dérapent, et le problème reste invisible tant que la publication n'est pas en ligne, sur un téléphone.
Localisation ou traduction
La définition du W3C est utile parce qu'elle est précise. Sa FAQ sur l'internationalisation décrit la localisation comme l'adaptation d'un contenu à un marché cible précis, une locale, et souligne qu'elle va bien au-delà de la traduction du texte : formats de date et de nombre, devise, conventions, culture.
Pour les contenus sociaux, l'écart est énorme. Une légende traduite garde la structure anglaise, la blague anglaise et l'appel à l'action anglais, simplement transposés dans une autre langue. Une légende localisée part de l'objectif de la publication, puis écrit ce qu'un rédacteur natif de ce marché aurait écrit.
Quelques exemples concrets de ce qu'une traduction laisse échapper :
- L'hébreu s'adresse au lecteur selon son genre. Un « Book your table » anglais n'a pas de genre. En hébreu, l'impératif est masculin, féminin ou pluriel, et les marques font des choix délibérés à ce sujet. Un agent qui traduit mécaniquement en choisira un au hasard à chaque publication, ce qui paraît incohérent sur quarante pages.
- L'arabe impose des choix de registre. L'arabe standard moderne et les dialectes régionaux coexistent, et le bon choix dépend de la marque et de l'audience. Le brief doit préciser lequel, et l'agent ne doit pas passer de l'un à l'autre.
- Les dates et les prix. « 11/10 » ne désigne pas le même jour selon les pays. Le symbole monétaire ne se place pas du même côté du nombre. En cas de doute, écrivez les dates en toutes lettres.
- Les fêtes et le rythme. La semaine de travail, les jours fériés et les périodes creuses varient selon les marchés. Une audience israélienne la veille d'une grande fête, ou une audience d'un pays à majorité musulmane pendant les soirées du ramadan, ne se comporte pas comme un mardi ordinaire.
La règle pratique pour l'agent : le brief est la source des faits, jamais la source des phrases.
Comment structurer un client multilingue dans Shager
Shager a été conçu d'abord pour l'hébreu, avec une interface de droite à gauche et un site entièrement disponible en anglais, et traite la légende de chaque compte comme un texte à part entière. Cela correspond à la manière dont un travail multilingue doit être organisé.
- Regroupez les comptes par langue. Utilisez
create_grouppour créer un groupe par langue, par exemple « Aurora HE », « Aurora AR », « Aurora EN ». Les groupes appartiennent à l'espace de travail du client. - Une publication par groupe de langue. Certains champs ne se définissent qu'une fois par publication :
cta_url,youtube_title,campaign. Des pages d'atterrissage et des titres YouTube propres à chaque langue exigent donc des publications distinctes par langue. Cela garde aussi un reporting par langue bien propre. - Des légendes par compte dans chaque publication.
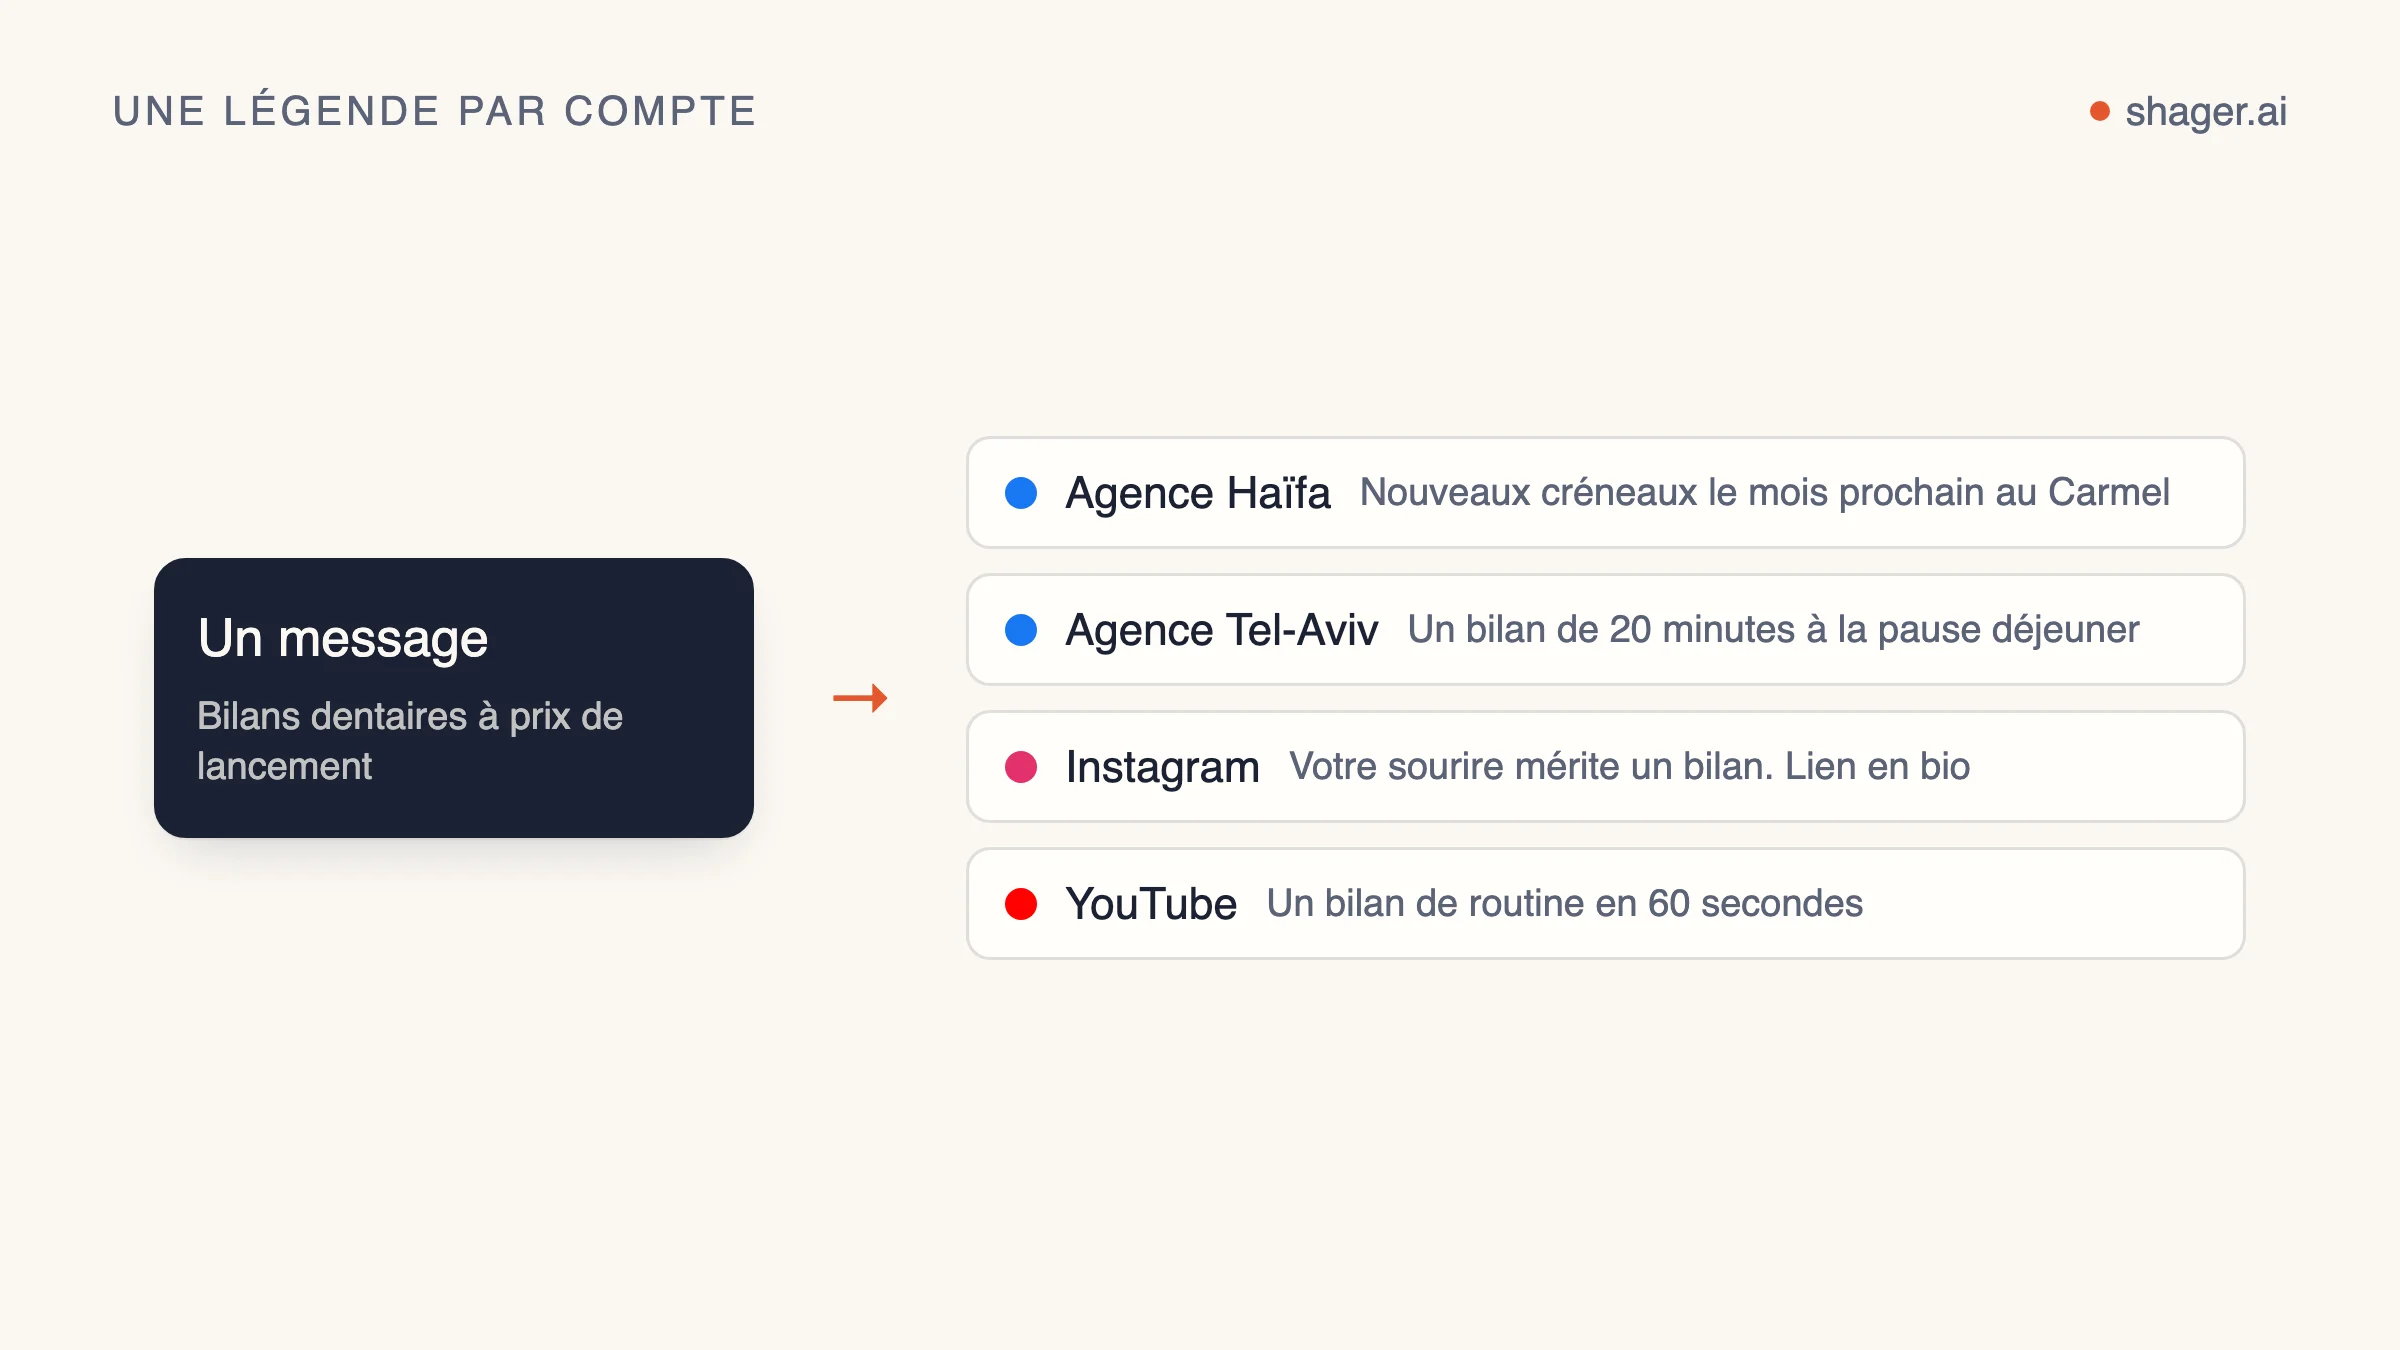
per_channelaccepte unecaptionet unfirst_commentpour chaquechannel_id. Même au sein d'une seule langue, variez la formulation d'un compte à l'autre, comme l'explique varier les légendes par compte avec l'IA.
Voici une publication en hébreu pour un client qui compte trois magasins :
{
  "tool": "create_post",
  "arguments": {
    "workspace_id": "ws_example",
    "group_ids": ["grp_aurora_he"],
    "caption": "הקולקציה החדשה מגיעה לסניפים ביום חמישי.",
    "cta_url": "https://aurora-example.co.il/he/new-collection",
    "campaign": "new-collection-he",
    "youtube_title": "הקולקציה החדשה של אורורה",
    "label": "Aurora new collection HE",
    "per_channel": [
      { "channel_id": "ch_fb_haifa",
        "caption": "חיפה, הקולקציה החדשה כבר בדרך. ביום חמישי היא אצלנו בסניף.",
        "first_comment": "לכל הפרטים ולתיאום ביקור:\nhttps://aurora-example.co.il/he/new-collection" },
      { "channel_id": "ch_fb_beersheva",
        "caption": "באר שבע, ביום חמישי נפתח את הארגזים. בואו לראות ראשונים." }
    ]
  }
}
Les publications en arabe et en anglais se créent de la même façon, avec leurs propres pages d'atterrissage et leurs propres campagnes. Comme Shager attribue à chaque compte son propre lien court et ses propres tags UTM, avec utm_content qui identifie le compte, les données de clics restent ventilées par compte et par langue, sans le moindre travail supplémentaire.
Les problèmes de droite à gauche que votre agent ne verra pas
Un modèle de langage produit une chaîne de caractères dans l'ordre logique. Le téléphone l'affiche à l'aide de l'algorithme bidirectionnel Unicode, qui décide visuellement où se place chaque segment de texte de gauche à droite et de droite à gauche. Quand une phrase en hébreu ou en arabe contient des mots anglais, des chiffres, des URL ou de la ponctuation, le résultat peut différer de ce que l'auteur voulait.
Le glossaire de l'internationalisation du W3C rappelle que, dans les écritures RTL, les nombres s'affichent de gauche à droite, et que le texte bidirectionnel est à l'origine de nombreuses difficultés avec ces écritures. Les symptômes habituels dans les légendes :
- La ponctuation saute à la mauvaise extrémité. Une phrase en hébreu qui se termine par un nom de marque anglais suivi d'un point peut afficher le point à gauche de la marque, au milieu de la ligne.
- Le sens de base s'inverse. Si une légende commence par un mot anglais ou un chiffre, une plateforme qui détermine le sens d'après le premier caractère « fort » affichera tout le paragraphe de gauche à droite. Les notes du W3C sur le texte bidirectionnel sur les réseaux sociaux, fondées sur des tests anciens, observaient que Facebook utilisait cette détection par premier caractère fort pour les commentaires. Les plateformes évoluent : vérifiez sur les applications actuelles.
- Les prix et les fourchettes se réordonnent. « 50 à 100 » écrit avec un trait d'union entre les chiffres au milieu d'un texte en hébreu peut s'afficher inversé par rapport à ce qu'attend le lecteur.
- Les hashtags en écritures mixtes. Un hashtag qui mélange caractères latins et hébreux peut se couper ou s'afficher bizarrement.
Les règles à donner à l'agent pour les légendes RTL
Elles vont dans les instructions permanentes de tout client qui a des comptes en hébreu ou en arabe.
- Commencez chaque légende RTL par un mot dans l'écriture RTL, jamais par un chiffre, un nom de marque en lettres latines ou un emoji.
- Ne terminez pas une légende RTL par un mot latin suivi d'une ponctuation. Reformulez pour que la phrase se termine dans l'écriture RTL.
- Placez les URL sur une ligne à part, jamais au milieu d'une phrase RTL.
- Écrivez les fourchettes et les prix en toutes lettres, ou restructurez la phrase, plutôt que de compter sur des symboles entre les nombres.
- Quand un nom de marque latin doit figurer en milieu de phrase et que l'affichage se casse, une marque de droite à gauche (U+200F) placée après le segment latin rétablit généralement l'ordre. Utilisez-la avec parcimonie, et seulement après test, car les caractères invisibles rendent le texte plus difficile à modifier par la suite.
- Avant de programmer, faites vérifier par un locuteur natif un exemple affiché par réseau, sur un téléphone. Une relecture sur capture d'écran repère ce qu'aucune vérification de chaîne ne détectera.
L'assistant de rédaction en hébreu de Shager aide côté humain, pour les équipes qui modifient ou valident des légendes en hébreu dans l'interface. L'agent a tout de même besoin des règles ci-dessus, parce qu'il écrit avant que quiconque ne relise.
La validation dans la langue du client
Quand un client d'un autre marché valide du contenu, il doit le voir dans sa propre langue. Les liens de validation de Shager permettent à un relecteur de valider sans se connecter ; l'agent les envoie avec request_approval, en indiquant un reviewer_name et, éventuellement, une adresse e-mail ou un numéro de téléphone. Envoyez la publication en hébreu à la responsable marketing hébréophone, et la publication en arabe à la personne qui lit réellement l'arabe. Un relecteur anglophone unique qui valide trois langues n'en valide en réalité qu'une seule. Le circuit de validation est décrit dans la validation humaine des publications d'agents.
Fuseaux horaires et calendriers
Un client dont l'audience arabophone se trouve dans un autre pays que son audience hébréophone peut avoir besoin d'horaires de publication différents selon la langue. Comme chaque langue fait l'objet d'une publication distincte, chacune peut avoir son propre schedule_at, avec le décalage calculé pour le bon fuseau. Le calendrier de Shager inclut les fêtes israéliennes ; pour les autres marchés, ajoutez les fêtes pertinentes au fichier de contexte du client. Les règles de programmation se trouvent dans la stratégie de programmation pour les agents.
FAQ
Une même publication peut-elle contenir des légendes en différentes langues selon les comptes ?
Oui. Les légendes per_channel sont du texte libre par compte : une seule publication peut donc mélanger les langues. Je recommande tout de même de séparer par langue dès que le lien, le titre YouTube ou l'horaire de publication doivent différer, car ces champs ne se définissent qu'une fois par publication.
L'agent doit-il rédiger un texte de référence en anglais et localiser à partir de celui-ci ?
Seulement si le brief est en anglais. Une meilleure pratique consiste à rédiger un brief de faits et d'objectifs dans la langue qu'utilise le client, puis à écrire des légendes natives à partir de ce brief pour chaque langue. Traduire une légende anglaise, c'est importer la structure anglaise dans toutes les autres langues.
Shager gère-t-il correctement le texte de droite à gauche ?
L'interface de Shager est conçue d'abord pour la lecture de droite à gauche, et les légendes partent vers les réseaux telles que l'agent les a écrites, à l'exception des liens, remplacés par le lien court suivi de chaque compte, et de la ligne d'appel à l'action quand vous définissez cta_url. L'affichage d'une légende dépend des applications de chaque réseau : les règles ci-dessus, et une vérification rapide sur téléphone, restent donc nécessaires.
Pour aller plus loin
Créez des groupes de langue dans l'espace de travail d'un client et lancez une seule publication dans chaque langue avant de passer à l'échelle. La page d'accueil des agents explique comment connecter votre agent si ce n'est pas encore fait.