Websites für KI-Agenten fit machen: llms.txt, Markdown-Seiten, OpenAPI, api-catalog und MCP-Server-Cards
Was eine agentenfähige Website veröffentlicht: llms.txt, Markdown-Seiten, OpenAPI, api-catalog nach RFC 9727 und eine MCP-Server-Card – am Beispiel shager.ai.
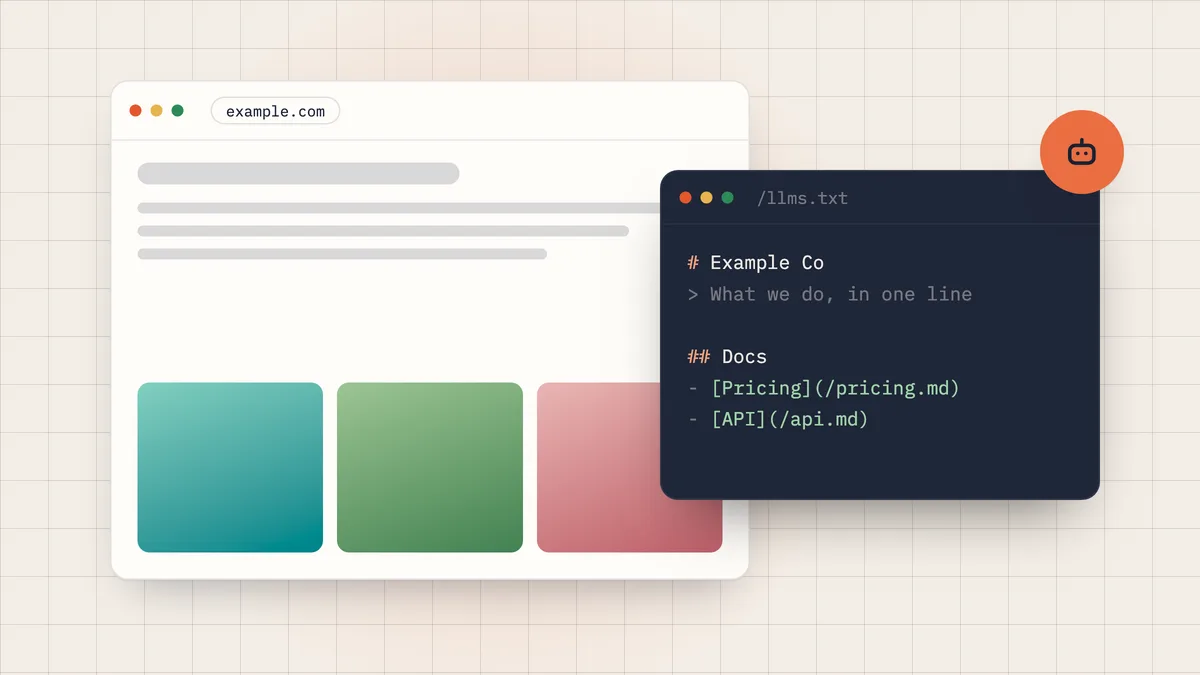
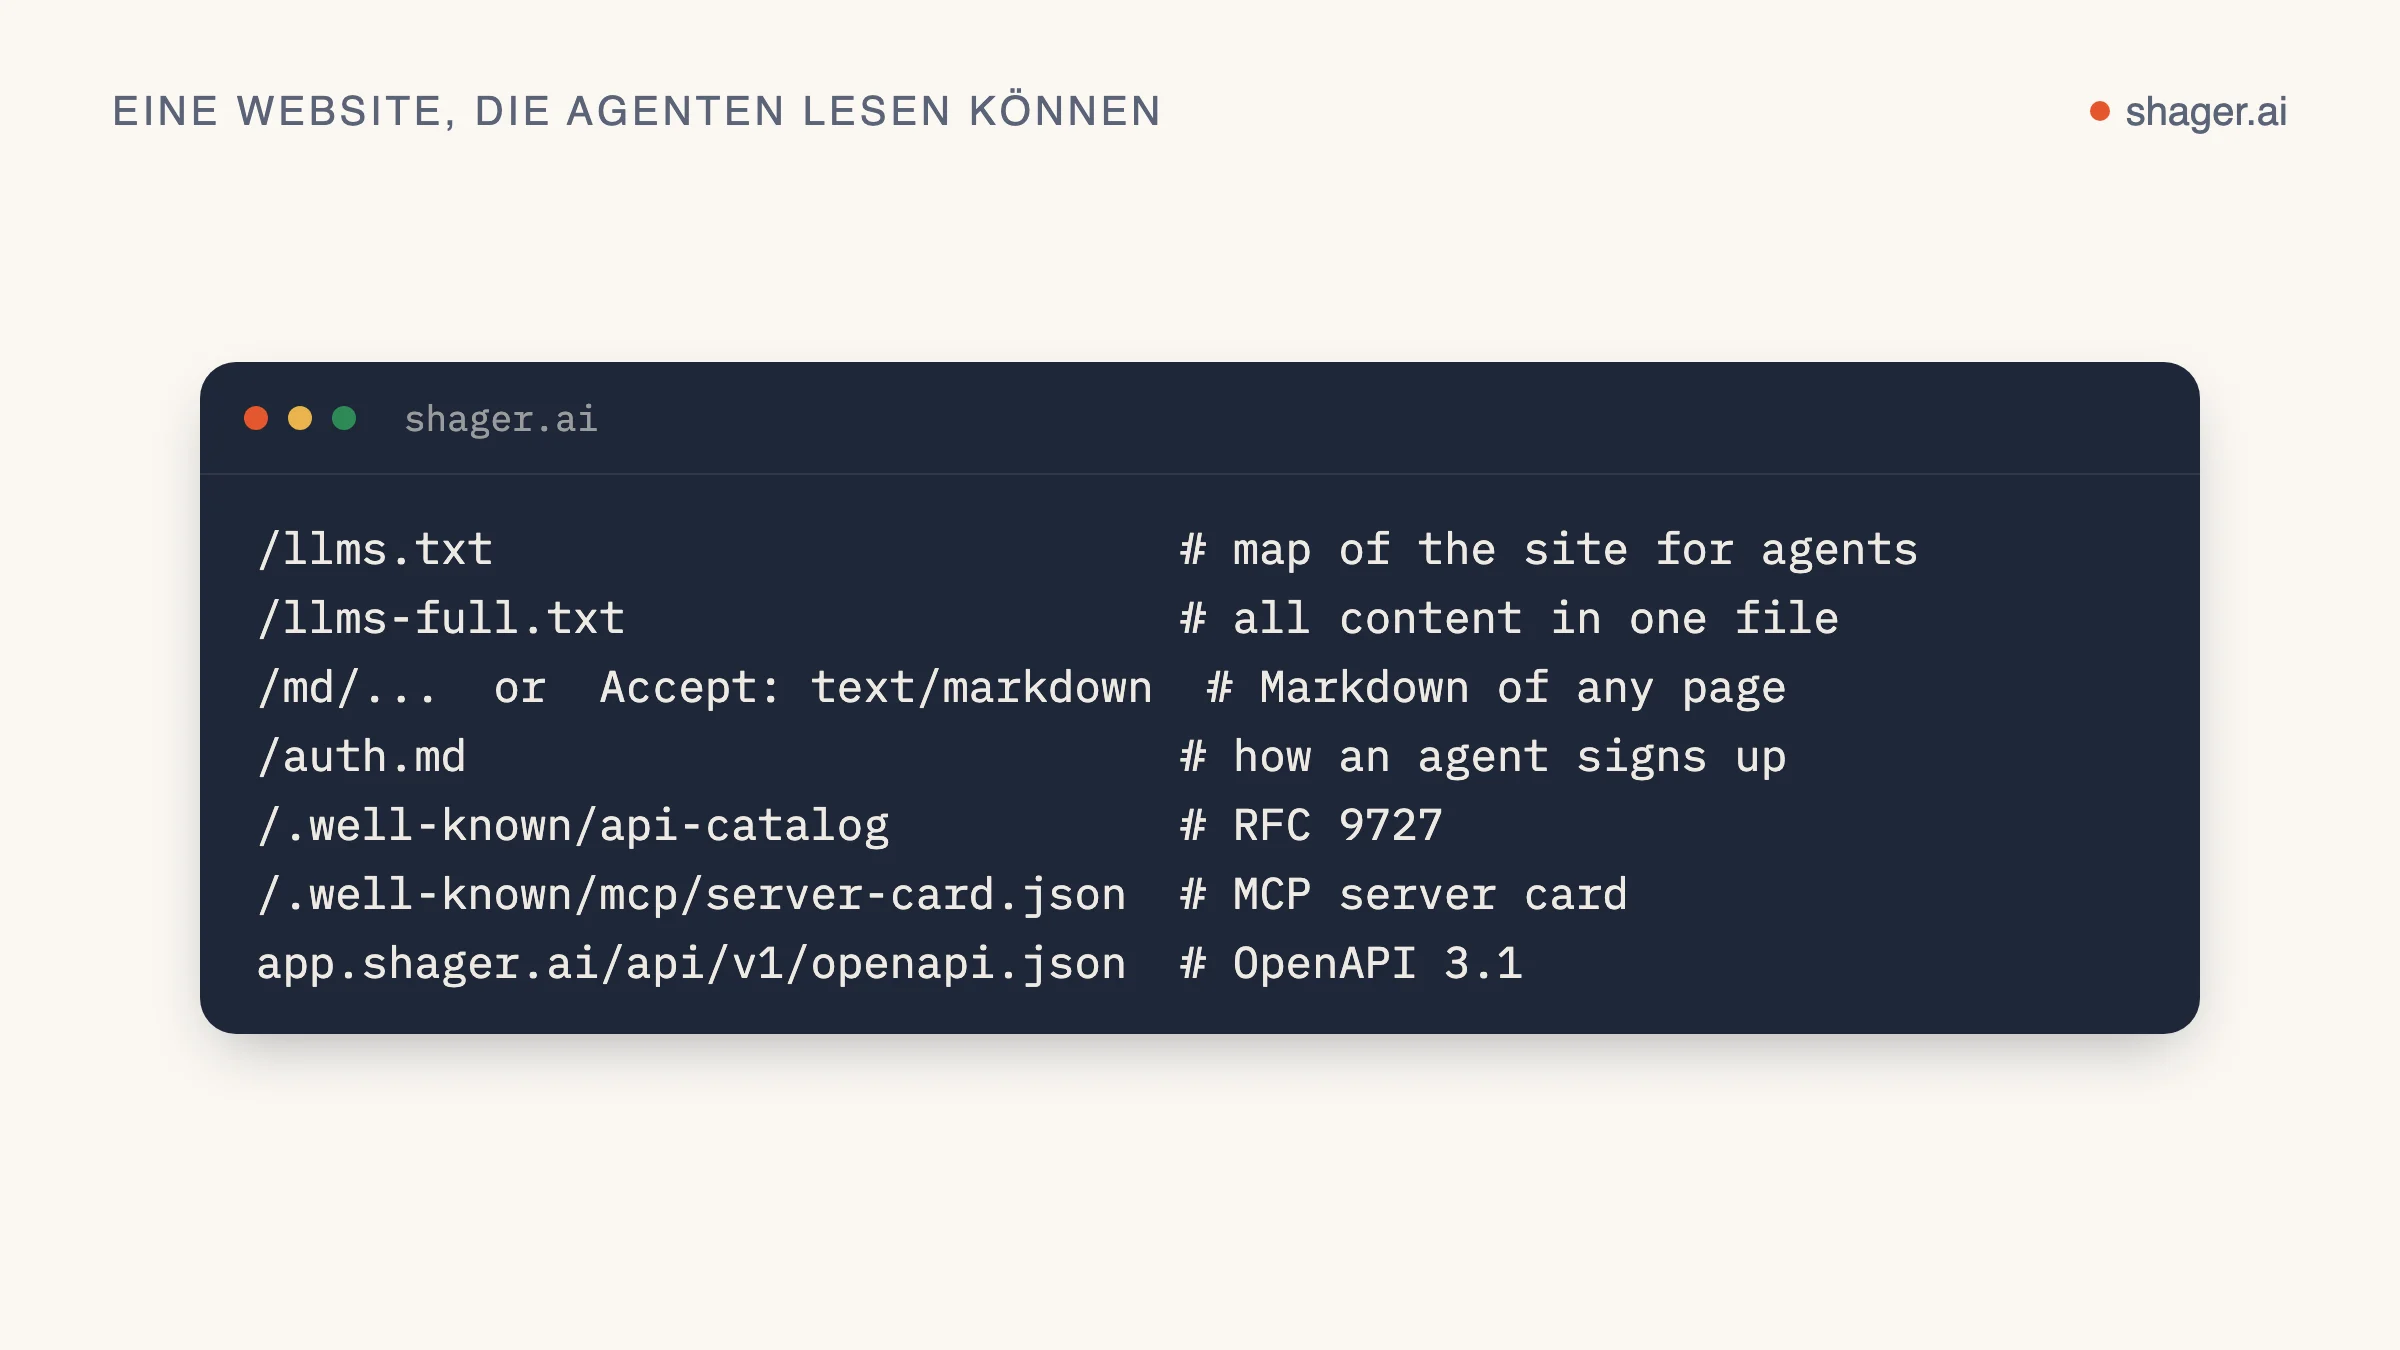
Eine agentenfähige Website gibt Software einen kurzen, vorhersehbaren Weg von „Was ist das?“ zu „Wie benutze ich das?“. In der Praxis sind das fünf Dateien oder Konventionen: eine Zusammenfassung unter /llms.txt, saubere Markdown-Versionen jeder Seite, eine OpenAPI-Beschreibung der API, ein /.well-known/api-catalog nach RFC 9727, der darauf verweist, und eine MCP-Server-Card, die beschreibt, wie man sich verbindet. Keine davon ist schwer zu veröffentlichen. Zusammen ermöglichen sie es einem Agenten, ein Produkt zu finden, zu verstehen und zu nutzen, ohne dass ein Mensch URLs in einen Chat kopiert.
Als durchgehendes Beispiel nehme ich shager.ai, weil jedes hier beschriebene Element dort live ist und du es beim Lesen mit curl abrufen kannst.
Warum der Aufwand, wenn keine Suchmaschine verspricht, diese Dateien zu lesen?
Zuerst die ehrliche Antwort. llms.txt ist ein Vorschlag, kein verabschiedeter Standard, und mir ist kein großer Modellanbieter bekannt, der öffentlich zugesagt hat, die Datei beim Retrieval zu nutzen. Der api-catalog ist ein echter IETF-RFC und MCP-Server-Cards sind eine akzeptierte MCP-Erweiterung, aber Crawler und Clients unterstützen sie bisher nur vereinzelt.
Für die Umsetzung spricht trotzdem ein praktischer Grund. Agenten landen immer öfter auf einer Website, weil ein Mensch sie dorthin geschickt hat, etwa mit „Registrier dich da und verbinde es“. In diesem Moment ruft der Agent Seiten direkt ab. Eine Website, die mit sauberem Markdown, einer klaren API-Beschreibung und einer Verbindungsanleitung antwortet, wird richtig genutzt. Eine Website, die mit 400 KB JavaScript antwortet, wird erraten.
llms.txt: die Eingangstür
Das Format ist auf llmstxt.org definiert. Es ist eine Markdown-Datei unter /llms.txt mit einer H1, die die Website benennt (der einzige Pflichtteil), einem Zitatblock als Zusammenfassung, optionalem Freitext und H2-Abschnitten mit Linklisten und kurzen Notizen. Ein Abschnitt mit dem Titel „Optional“ markiert Links, die ein Agent überspringen kann, wenn er einen kürzeren Kontext braucht.
Die Datei von Shager folgt diesem Aufbau. Der Anfang sieht so aus:
# Shager

> Shager (שגר) is agent-first distribution infrastructure for agencies and
> marketers: your agent creates, Shager ships it everywhere. ...

## For AI agents
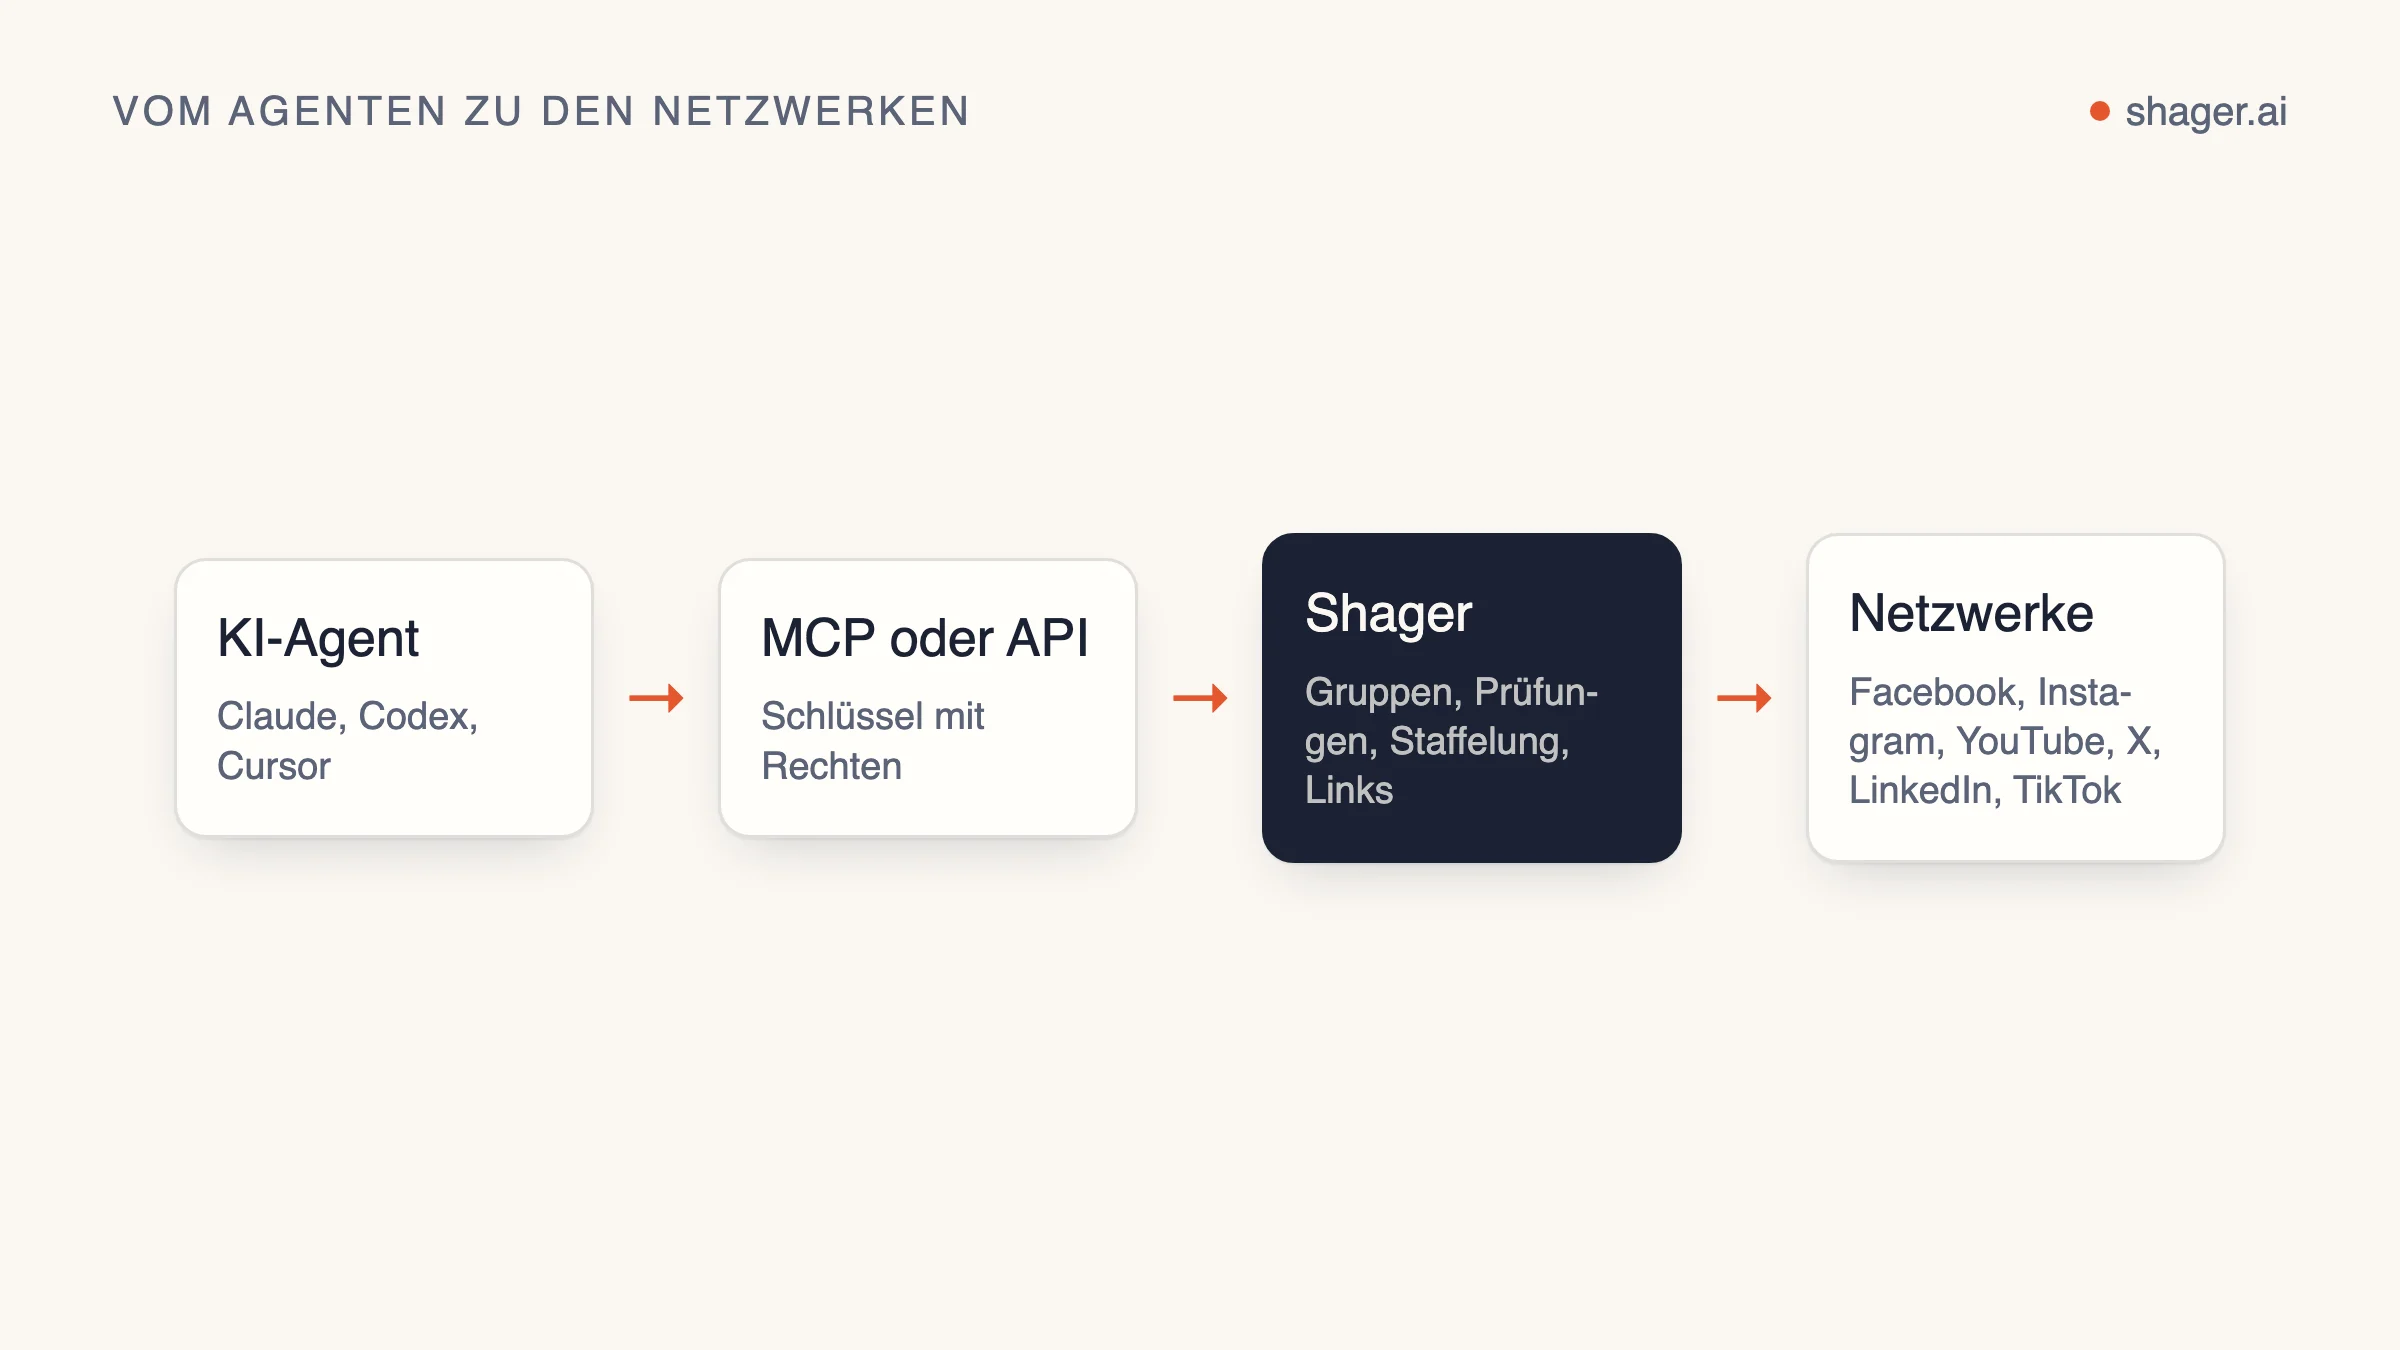
- MCP server: https://app.shager.ai/api/mcp (OAuth sign-in for any MCP client that supports it, or Authorization: Bearer <api key>)
- REST API: https://app.shager.ai/api/v1 ...
- Self sign-up: POST https://app.shager.ai/api/v1/agent/signup ...
Einige Entscheidungen lohnen sich zum Nachmachen. Der Agenten-Abschnitt steht vor den Marketingseiten, weil ein Agent, der die Datei liest, meistens handeln will. Die Preise stehen als klare Zahlen in der Datei selbst, nicht hinter einem Link. Einschränkungen werden offen benannt (zum Beispiel, dass TikTok-Beiträge privat bleiben, bis TikTok die App freigibt), damit ein Agent einem Nutzer nichts verspricht, was das Produkt noch nicht kann. Und es gibt ein ergänzendes /llms-full.txt mit allen Inhalten in einer Datei, für Agenten, die lieber nur einmal abrufen.
Markdown-Versionen jeder Seite
Derselbe Vorschlag empfiehlt, von jeder Seite eine saubere Markdown-Version auszuliefern und sie mit rel="alternate" und type="text/markdown" anzukündigen, dazu rel="describedby" mit Verweis auf die llms.txt, die die Seite abdeckt. Beides geht als HTML-Element <link> oder als HTTP-Header Link.
Shager macht das auf zwei Wegen. Jede Seite hat einen Markdown-Zwilling unter /md/, /en/pricing gibt es also auch unter /md/en/pricing. Und eine Anfrage an die normale URL mit Accept: text/markdown liefert direkt das Markdown:
curl -s -H "Accept: text/markdown" https://shager.ai/en/pricing | head -5
Jede HTML-Seite schickt außerdem einen Link-Header, der ihre Alternativen ankündigt:
link: </.well-known/api-catalog>; rel="api-catalog",
      </llms.txt>; rel="describedby"; type="text/plain",
      </md/en/agents>; rel="alternate"; type="text/markdown"
Ein Detail, das für die Suche wichtig ist: Die Markdown-Antworten tragen x-robots-tag: noindex, damit Suchmaschinen nicht jede Seite doppelt indexieren. Das Markdown ist für Agenten; die HTML-Seite bleibt die kanonische Seite für Menschen und Suchergebnisse.
OpenAPI: der Vertrag
Für alles, was ein Agent aufrufen soll, ist ein OpenAPI-Dokument nach wie vor das Nützlichste, was du veröffentlichen kannst. Es liefert Operation-IDs, Parameter, Schemas und Authentifizierung in einer Form, die Agenten und Codegeneratoren gleichermaßen lesen.
Das von Shager liegt unter app.shager.ai/api/v1/openapi.json, Version 3.1. Drei Konventionen darin helfen speziell Agenten. Die Operation-IDs entsprechen den Namen der MCP-Tools (create_post, get_analytics), wer also eine Schnittstelle kennt, kennt auch die andere. Jede Operation gibt in der Erweiterung x-scope an, welche Schlüsselberechtigung sie braucht. Und die Feldbeschreibungen sind als Anweisungen formuliert: Beim Text-Override per_channel steht zum Beispiel, dass es empfohlen ist, die Formulierung pro Konto zu variieren. Beschreibungen sind Platz für Prompts – nutz ihn.
api-catalog: Software zeigen, wo die APIs sind
RFC 9727, im Juni 2025 von der IETF veröffentlicht, definiert eine Well-known-URI, /.well-known/api-catalog, und eine Link-Relation api-catalog. Eine Anfrage dorthin liefert ein Dokument, das die APIs eines Anbieters mit Links zu ihren Beschreibungen und ihrer Dokumentation auflistet. Der RFC schreibt für das Dokument den Medientyp application/linkset+json vor und nutzt Link-Relationen wie service-desc für maschinenlesbare Beschreibungen wie OpenAPI und service-doc für Dokumentation für Menschen.
Das ist der Katalog von Shager, vollständig:
{
  "linkset": [
    {
      "anchor": "https://app.shager.ai/api/v1",
      "service-desc": [
        { "href": "https://app.shager.ai/api/v1/openapi.json", "type": "application/openapi+json" }
      ],
      "service-doc": [
        { "href": "https://shager.ai/en/agents", "type": "text/html" },
        { "href": "https://shager.ai/md/en/agents", "type": "text/markdown" }
      ]
    }
  ]
}
Er ist kurz, weil Shager eine einzige API hat. Ein Unternehmen mit mehreren APIs würde pro API einen Eintrag aufführen. Über den oben gezeigten Link rel="api-catalog" im Link-Header jeder Seite findet ein Client, der auf irgendeiner Seite landet, den Katalog, ohne den Pfad raten zu müssen.
MCP-Server-Cards: wissen, wie man sich verbindet, bevor man sich verbindet
Ein MCP-Client muss wissen, wo ein Server liegt und wie man sich authentifiziert, bevor er tools/list aufrufen kann. SEP-2127 definiert genau dafür MCP-Server-Cards: ein statisches JSON-Dokument, das die Identität eines Remote-Servers beschreibt, seine Transport-Endpunkte, erforderliche Header und unterstützte Protokollversionen. Das SEP reserviert <streamable-http-url>/server-card als empfohlenen Ort und beschreibt eine Erkennung auf Domain-Ebene über einen AI Catalog, der auf Cards verweist. Das detaillierte Schema liegt im Repository der Erweiterung.
Shager liefert seine Card am empfohlenen Ort aus, https://app.shager.ai/api/mcp/server-card, und zusätzlich unter https://shager.ai/.well-known/mcp/server-card.json, einem Pfad, den manche Discovery-Tools abfragen. Der Verbindungsteil lautet:
{
  "name": "ai.shager/shager",
  "title": "Shager",
  "version": "1.0.0",
  "remotes": [
    {
      "type": "streamable-http",
      "url": "https://app.shager.ai/api/mcp",
      "headers": [
        { "name": "Authorization", "isRequired": true, "isSecret": true,
          "description": "Bearer shgr_… API key (self-signup: POST /api/v1/agent/signup)" }
      ]
    }
  ]
}
Die Card listet außerdem die Tools von Shager mit einzeiligen Beschreibungen auf. Beachte, dass das SEP Tools bewusst aus den Standardfeldern der Card heraushält, weil das, was ein Server anbietet, je nach Nutzer und Sitzung variieren kann. Betrachte jede Tool-Liste in einer Card als Vorschau; maßgeblich ist der Live-Aufruf tools/list.
Zwei Extras: auth.md und eine Skill-Datei
Discovery sagt einem Agenten, was es gibt. Zwei weitere Dateien sagen ihm, was er tun soll.
/auth.md ist eine schlichte Anleitung, wie ein Agent Zugang bekommt: entdecken, sich über den Self-Signup-Aufruf registrieren, den Schlüssel verwenden, den Claim-Link an einen Menschen übergeben – und wie der Mensch den Zugang widerruft. Sie nennt auch die Regeln: Rate Limit, Fehlerformat, Textvariation, ausschließlich offizielle APIs. Ein Agent kann sie von oben nach unten abarbeiten.
https://shager.ai/skills/shager/SKILL.md ist eine Skill-Datei in dem Format, das Claude Code für Skills verwendet: YAML-Frontmatter mit einem name und einer description, die dem Modell sagt, wann es den Skill einsetzen soll, danach nummerierte Anweisungen. Installiere sie, und der Agent kennt den Shager-Workflow ohne langen Prompt. Wie du deine eigene Version baust, steht in einen Claude-Skill für Shager bauen.
Checkliste für deine eigene Website
/llms.txtmit einer H1, einer Zusammenfassung in einem Absatz, dem Agenten-Abschnitt zuerst und ehrlichen Hinweisen bei allem, was noch nicht live ist.- Eine Markdown-Version jeder Seite, angekündigt mit
rel="alternate"undtype="text/markdown", markiert mitnoindex. - Ein OpenAPI-Dokument mit Operation-IDs, die zu deinen MCP-Tools passen, und Beschreibungen, die als Anweisungen formuliert sind.
/.well-known/api-catalogalsapplication/linkset+json, von jeder Seite aus verlinkt mitrel="api-catalog".- Eine MCP-Server-Card unter
<your MCP URL>/server-card. - Eine verständliche Zugangsanleitung wie
auth.md, falls Agenten sich registrieren können.
FAQ
Ist llms.txt dasselbe wie robots.txt?
Nein. robots.txt sagt Crawlern, was sie abrufen dürfen. llms.txt ist ein kuratierter Wegweiser zu dem, was sich zu lesen lohnt, geschrieben für Sprachmodelle. Sie erlaubt und verbietet nichts.
Verbessert die Veröffentlichung dieser Dateien das Ranking?
Dafür gibt es keine veröffentlichten Belege, und keine Suchmaschine hat erklärt, llms.txt als Rankingsignal zu nutzen. Der Nutzen liegt darin, dass Agenten dein Produkt richtig verwenden, sobald sie da sind. Die HTML-Seiten müssen für die Suche aus eigener Kraft überzeugen.
Brauche ich einen MCP-Server, um davon zu profitieren?
Nein. llms.txt, Markdown-Seiten, OpenAPI und ein api-catalog sind für jede Website mit Dokumentation oder API nützlich. Die Server-Card ist nur relevant, wenn du einen Remote-MCP-Server betreibst.
Wie es weitergeht
Ruf die Dateien von Shager mit curl ab und vergleiche sie mit deiner eigenen Website. Was ein Agent nach der Discovery tut, zeigt der Einstiegspunkt für Agenten.