Un sito pronto per gli agenti: llms.txt, pagine in Markdown, OpenAPI, api-catalog e server card MCP
Cosa pubblica un sito pronto per gli agenti: llms.txt, pagine in Markdown, OpenAPI, l'api-catalog RFC 9727 e una server card MCP, con shager.ai come esempio.
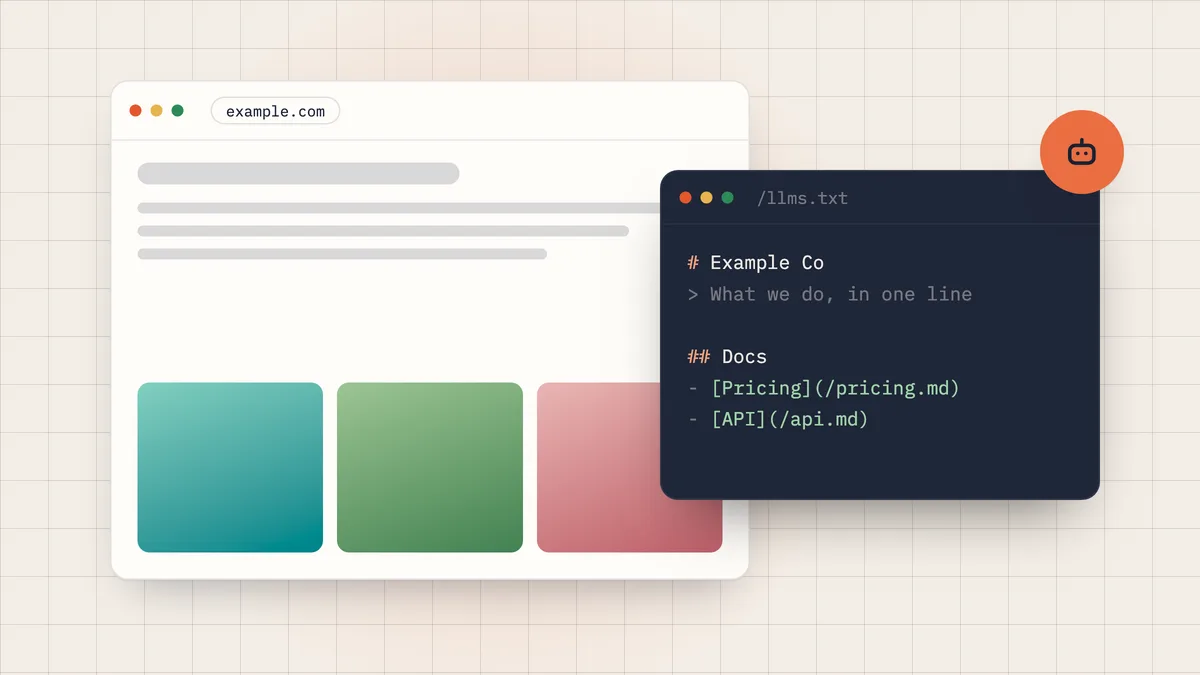
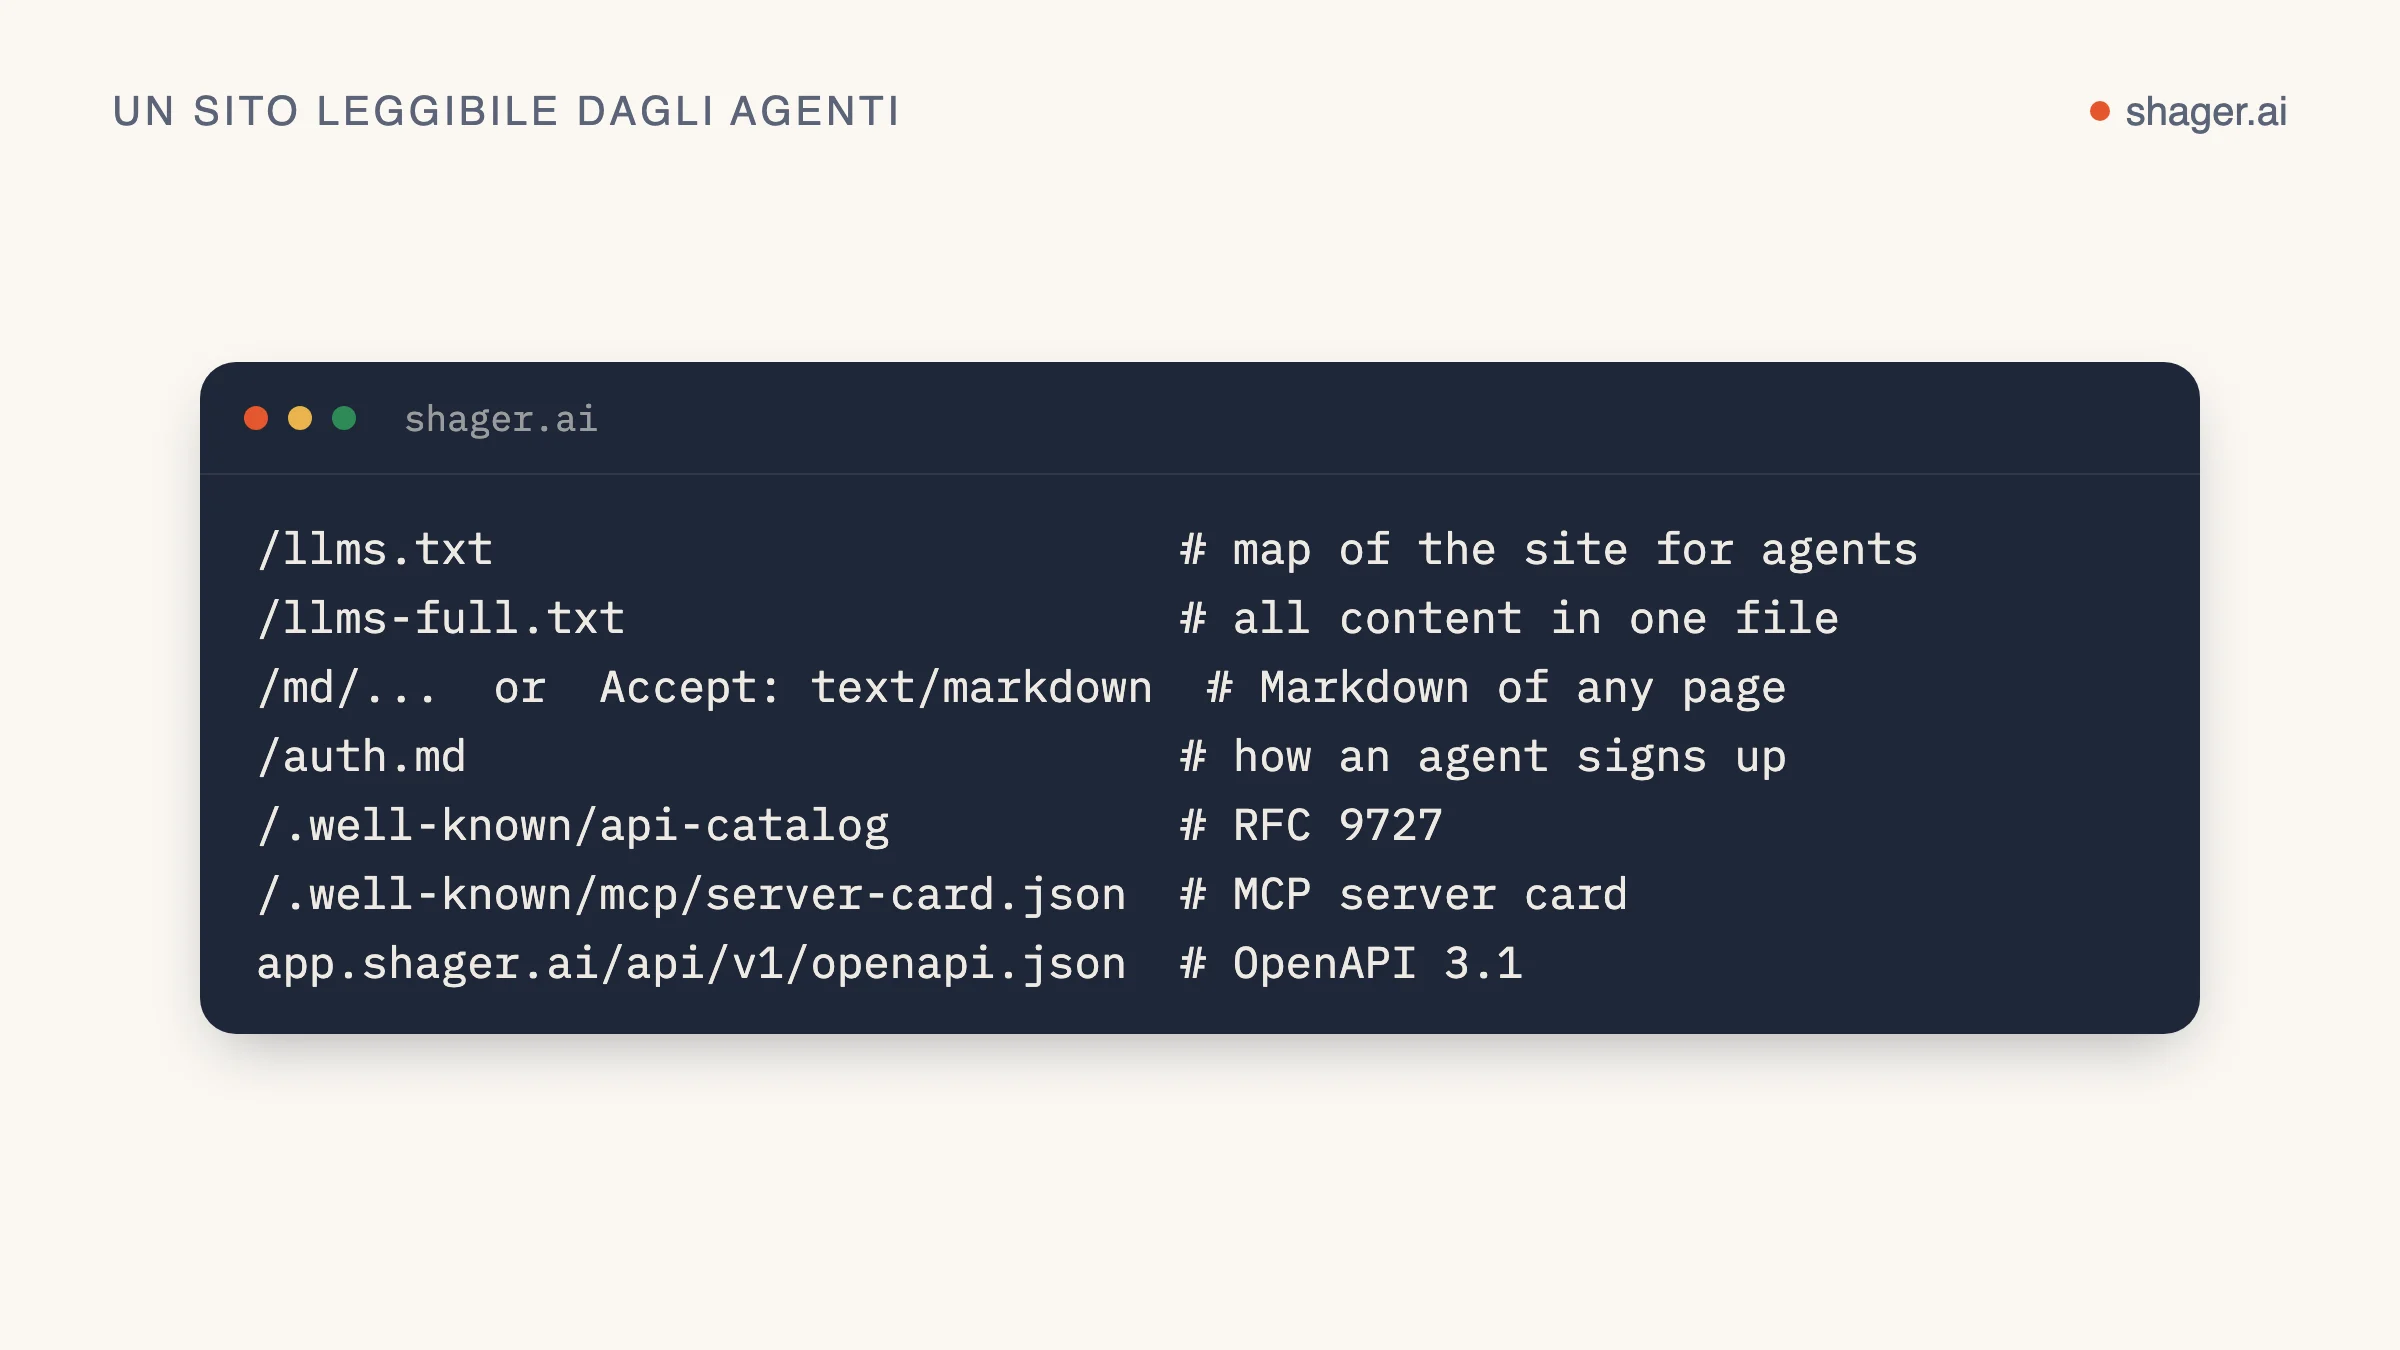
Un sito pronto per gli agenti offre al software un percorso breve e prevedibile da "che cos'è?" a "come si usa?". In pratica significa cinque file o convenzioni: un riepilogo in /llms.txt, versioni Markdown pulite di ogni pagina, una descrizione OpenAPI dell'API, un /.well-known/api-catalog secondo l'RFC 9727 che punta a quella descrizione e una server card MCP che spiega come collegarsi. Nessuno di questi è difficile da pubblicare. Insieme permettono a un agente di trovare un prodotto, capirlo e cominciare a usarlo senza che una persona debba incollare URL in una chat.
Userò shager.ai come esempio dall'inizio alla fine, perché ogni elemento descritto qui è online e puoi scaricarlo con curl mentre leggi.
Perché farlo, se nessun motore promette di leggere questi file?
Prima di tutto, onestà. llms.txt è una proposta, non uno standard ratificato, e non mi risulta che un grande fornitore di modelli si sia impegnato pubblicamente a usarlo per il recupero delle informazioni. L'api-catalog è un vero RFC dell'IETF e le server card MCP sono un'estensione MCP accettata, ma l'adozione da parte di crawler e client è ancora agli inizi.
Le ragioni per farlo comunque sono pratiche. Sempre più spesso gli agenti arrivano su un sito perché una persona glielo ha chiesto, per esempio "registrati qui e collegalo". In quel momento l'agente scarica direttamente le pagine. Un sito che risponde con un Markdown pulito, una descrizione esplicita dell'API e una ricetta per collegarsi viene usato nel modo giusto. Un sito che risponde con 400 KB di JavaScript viene interpretato a tentoni.
llms.txt: la porta d'ingresso
Il formato è definito su llmstxt.org. È un file Markdown in /llms.txt con un H1 che dà il nome al sito (l'unica parte obbligatoria), un riepilogo in un blockquote, testo libero facoltativo e sezioni H2 con elenchi di link accompagnati da brevi note. Una sezione intitolata "Optional" segnala i link che un agente può saltare quando gli serve un contesto più corto.
Il file di Shager segue questa forma. L'inizio è così:
# Shager

> Shager (שגר) is agent-first distribution infrastructure for agencies and
> marketers: your agent creates, Shager ships it everywhere. ...

## For AI agents
- MCP server: https://app.shager.ai/api/mcp (OAuth sign-in for any MCP client that supports it, or Authorization: Bearer <api key>)
- REST API: https://app.shager.ai/api/v1 ...
- Self sign-up: POST https://app.shager.ai/api/v1/agent/signup ...
Alcune scelte vale la pena copiarle. La sezione per gli agenti viene prima delle pagine di marketing, perché un agente che legge il file di solito vuole agire. I prezzi sono scritti in cifre direttamente nel file, non dietro un link. I limiti sono dichiarati senza giri di parole (per esempio, i post su TikTok restano privati finché TikTok non approva l'app), così un agente non promette a un utente qualcosa che il prodotto non sa ancora fare. E c'è un file gemello, /llms-full.txt, con tutti i contenuti in un unico file per gli agenti che preferiscono una sola richiesta.
Una versione Markdown di ogni pagina
La stessa proposta suggerisce di servire una versione Markdown pulita di ogni pagina e consiglia di segnalarla con rel="alternate" e type="text/markdown", più un rel="describedby" che punta al llms.txt di riferimento per quella pagina. Entrambi possono essere elementi HTML <link> oppure un header HTTP Link.
Shager lo fa in due modi. Ogni pagina ha un gemello Markdown sotto /md/, quindi /en/pricing si trova anche in /md/en/pricing. E una richiesta all'URL normale con Accept: text/markdown riceve direttamente il Markdown:
curl -s -H "Accept: text/markdown" https://shager.ai/en/pricing | head -5
Ogni pagina HTML invia anche un header Link che annuncia le sue alternative:
link: </.well-known/api-catalog>; rel="api-catalog",
      </llms.txt>; rel="describedby"; type="text/plain",
      </md/en/agents>; rel="alternate"; type="text/markdown"
Un dettaglio che conta per la SEO: le risposte in Markdown portano x-robots-tag: noindex, così i motori di ricerca non indicizzano due copie di ogni pagina. Il Markdown è per gli agenti; l'HTML resta la pagina canonica per le persone e per i risultati di ricerca.
OpenAPI: il contratto
Per tutto ciò che un agente dovrà chiamare, un documento OpenAPI resta la cosa più utile che puoi pubblicare. Fornisce ID delle operazioni, parametri, schemi e autenticazione in una forma che leggono sia gli agenti sia i generatori di codice.
Quello di Shager si trova su app.shager.ai/api/v1/openapi.json, versione 3.1. Tre convenzioni aiutano in particolare gli agenti. Gli ID delle operazioni coincidono con i nomi degli strumenti MCP (create_post, get_analytics), quindi un agente che ha imparato un'interfaccia conosce anche l'altra. Ogni operazione dichiara il permesso richiesto alla chiave in un'estensione x-scope. E le descrizioni dei campi sono scritte come istruzioni: per esempio, quella dell'override del testo per_channel dice che è consigliabile variare la formulazione per ogni account. Le descrizioni sono spazio di prompt: sfruttalo.
api-catalog: dire al software dove sono le API
L'RFC 9727, pubblicato dall'IETF a giugno 2025, definisce un URI well-known, /.well-known/api-catalog, e una relazione di link api-catalog. Una richiesta a quell'indirizzo restituisce un documento che elenca le API di un editore, con i link alle loro descrizioni e alla documentazione. L'RFC impone per il documento il media type application/linkset+json e usa relazioni di link come service-desc per le descrizioni leggibili dalle macchine, come OpenAPI, e service-doc per la documentazione destinata alle persone.
Questo è il catalogo di Shager, completo:
{
  "linkset": [
    {
      "anchor": "https://app.shager.ai/api/v1",
      "service-desc": [
        { "href": "https://app.shager.ai/api/v1/openapi.json", "type": "application/openapi+json" }
      ],
      "service-doc": [
        { "href": "https://shager.ai/en/agents", "type": "text/html" },
        { "href": "https://shager.ai/md/en/agents", "type": "text/markdown" }
      ]
    }
  ]
}
È breve perché Shager ha una sola API. Un'azienda che ne ha diverse elencherebbe una voce per ciascuna. Il link rel="api-catalog" presente nell'header Link di ogni pagina, visto sopra, è il modo in cui un client arrivato su una pagina qualsiasi trova il catalogo senza dover indovinare il percorso.
Server card MCP: come collegarsi prima di collegarsi
Un client MCP deve sapere dove si trova un server e come autenticarsi prima di poter chiamare tools/list. La SEP-2127 definisce le MCP Server Card proprio per questo: un documento JSON statico che descrive l'identità di un server remoto, i suoi endpoint di trasporto, gli header richiesti e le versioni del protocollo supportate. La SEP riserva <streamable-http-url>/server-card come posizione consigliata e descrive una scoperta a livello di dominio tramite un AI Catalog che rimanda alle card. Lo schema dettagliato si trova nel repository dell'estensione.
Shager serve la sua card nella posizione consigliata, https://app.shager.ai/api/mcp/server-card, e anche in https://shager.ai/.well-known/mcp/server-card.json, un percorso che alcuni strumenti di scoperta vanno a cercare. La parte relativa al collegamento è questa:
{
  "name": "ai.shager/shager",
  "title": "Shager",
  "version": "1.0.0",
  "remotes": [
    {
      "type": "streamable-http",
      "url": "https://app.shager.ai/api/mcp",
      "headers": [
        { "name": "Authorization", "isRequired": true, "isSecret": true,
          "description": "Bearer shgr_… API key (self-signup: POST /api/v1/agent/signup)" }
      ]
    }
  ]
}
La card elenca anche gli strumenti di Shager, ciascuno con una descrizione di una riga. Nota che la SEP tiene volutamente gli strumenti fuori dai campi standard della card, perché ciò che un server espone può variare a seconda dell'utente e della sessione. Considera qualsiasi elenco di strumenti in una card come un'anteprima: la fonte di verità è la chiamata tools/list in tempo reale.
Due extra: auth.md e un file di skill
La scoperta dice a un agente cosa esiste. Altri due file gli dicono cosa fare.
/auth.md è una ricetta semplice per spiegare a un agente come ottenere l'accesso: scoperta, registrazione con la chiamata di self-signup, uso della chiave, consegna del link di rivendicazione a una persona e modo in cui la persona può revocarla. Indica anche le regole: limite di richieste, formato degli errori, variazione dei testi, solo API ufficiali. Un agente può seguirla dall'inizio alla fine.
https://shager.ai/skills/shager/SKILL.md è un file di skill nel formato che Claude Code usa per le skill: frontmatter YAML con un name e una description che dice al modello quando usarla, poi istruzioni numerate. Installala e l'agente conosce il flusso di lavoro di Shager senza bisogno di un prompt lungo. Come crearne una tua lo spieghiamo in creare una skill di Claude per Shager.
Una checklist per il tuo sito
/llms.txtcon un H1, un riepilogo di un paragrafo, la sezione per gli agenti in cima ed etichette oneste per tutto ciò che non è ancora disponibile.- Una versione Markdown di ogni pagina, segnalata con
rel="alternate"etype="text/markdown", marcatanoindex. - Un documento OpenAPI con ID delle operazioni uguali ai tuoi strumenti MCP e descrizioni scritte come istruzioni.
/.well-known/api-catalogcomeapplication/linkset+json, collegato da ogni pagina conrel="api-catalog".- Una server card MCP in
<your MCP URL>/server-card. - Una ricetta di accesso in linguaggio semplice come
auth.md, se gli agenti possono registrarsi.
Domande frequenti
llms.txt è la stessa cosa di robots.txt?
No. robots.txt dice ai crawler cosa possono scaricare. llms.txt è una guida selezionata a ciò che vale la pena leggere, scritta per i modelli linguistici. Non concede né vieta nulla.
Pubblicare questi file migliora il posizionamento nei motori di ricerca?
Non ci sono prove pubblicate in tal senso e nessun motore di ricerca ha dichiarato di usare llms.txt come fattore di ranking. Il valore sta nel fatto che gli agenti, una volta arrivati, usano correttamente il tuo prodotto. Le pagine HTML devono restare forti per la ricerca per meriti propri.
Mi serve un server MCP per trarne vantaggio?
No. llms.txt, pagine Markdown, OpenAPI e un api-catalog sono utili per qualsiasi sito con documentazione o un'API. La server card serve solo se gestisci un server MCP remoto.
Da dove continuare
Scarica i file di Shager con curl e confrontali con il tuo sito. Per sapere cosa fa un agente dopo la scoperta, la tappa successiva è il punto di ingresso per gli agenti.