Web サイトを AI エージェント対応にする:llms.txt、Markdown 版ページ、OpenAPI、api-catalog、MCP サーバーカード
エージェント対応サイトに必要な llms.txt、Markdown 版ページ、OpenAPI、api-catalog、MCP サーバーカードを shager.ai を例に解説。
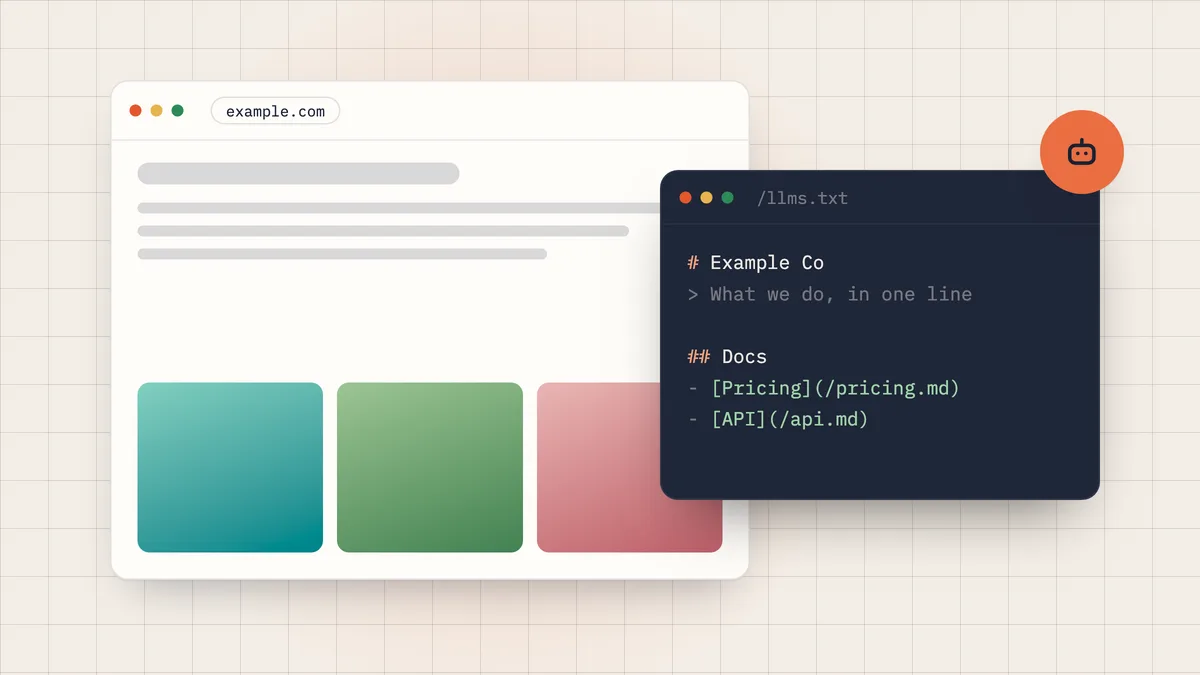
エージェント対応の Web サイトとは、ソフトウェアが「これは何か」から「どう使うのか」までを、短く迷わずたどれるサイトのことです。具体的には、5つのファイルや仕組みを用意します。概要をまとめた /llms.txt、各ページのすっきりした Markdown 版、API を記述した OpenAPI、それを指し示す RFC 9727 の /.well-known/api-catalog、そして接続方法を記した MCP サーバーカードです。どれも公開するのは難しくありません。これらがそろえば、人がチャットに URL をコピーしなくても、エージェントが自力でプロダクトを見つけ、理解し、使い始められます。
この記事では、一貫して shager.ai を実例として使います。ここで紹介するものはすべて実際に公開されており、読みながら curl で一つひとつ取得できます。
これらのファイルを読むと約束しているエンジンがないのに、なぜ用意するのか
まず正直にお伝えします。llms.txt は提案段階のもので、正式に承認された標準ではありません。また、主要なモデル提供企業が検索や取得の処理でこれを使うと公に表明した例も、私の知る限りありません。api-catalog は IETF の正式な RFC で、MCP サーバーカードも MCP の拡張として採択されていますが、クローラーやクライアントでの採用はまだ始まったばかりです。
それでも用意する理由は、実務的なものです。エージェントがサイトを訪れるきっかけは、「これに登録して接続しておいて」のように人から頼まれたから、というケースが増えています。そのときエージェントはページを直接取得します。すっきりした Markdown で応答し、API の記述と接続手順がはっきり示されているサイトは、正しく使われます。400 KB の JavaScript を返すサイトは、推測で扱われます。
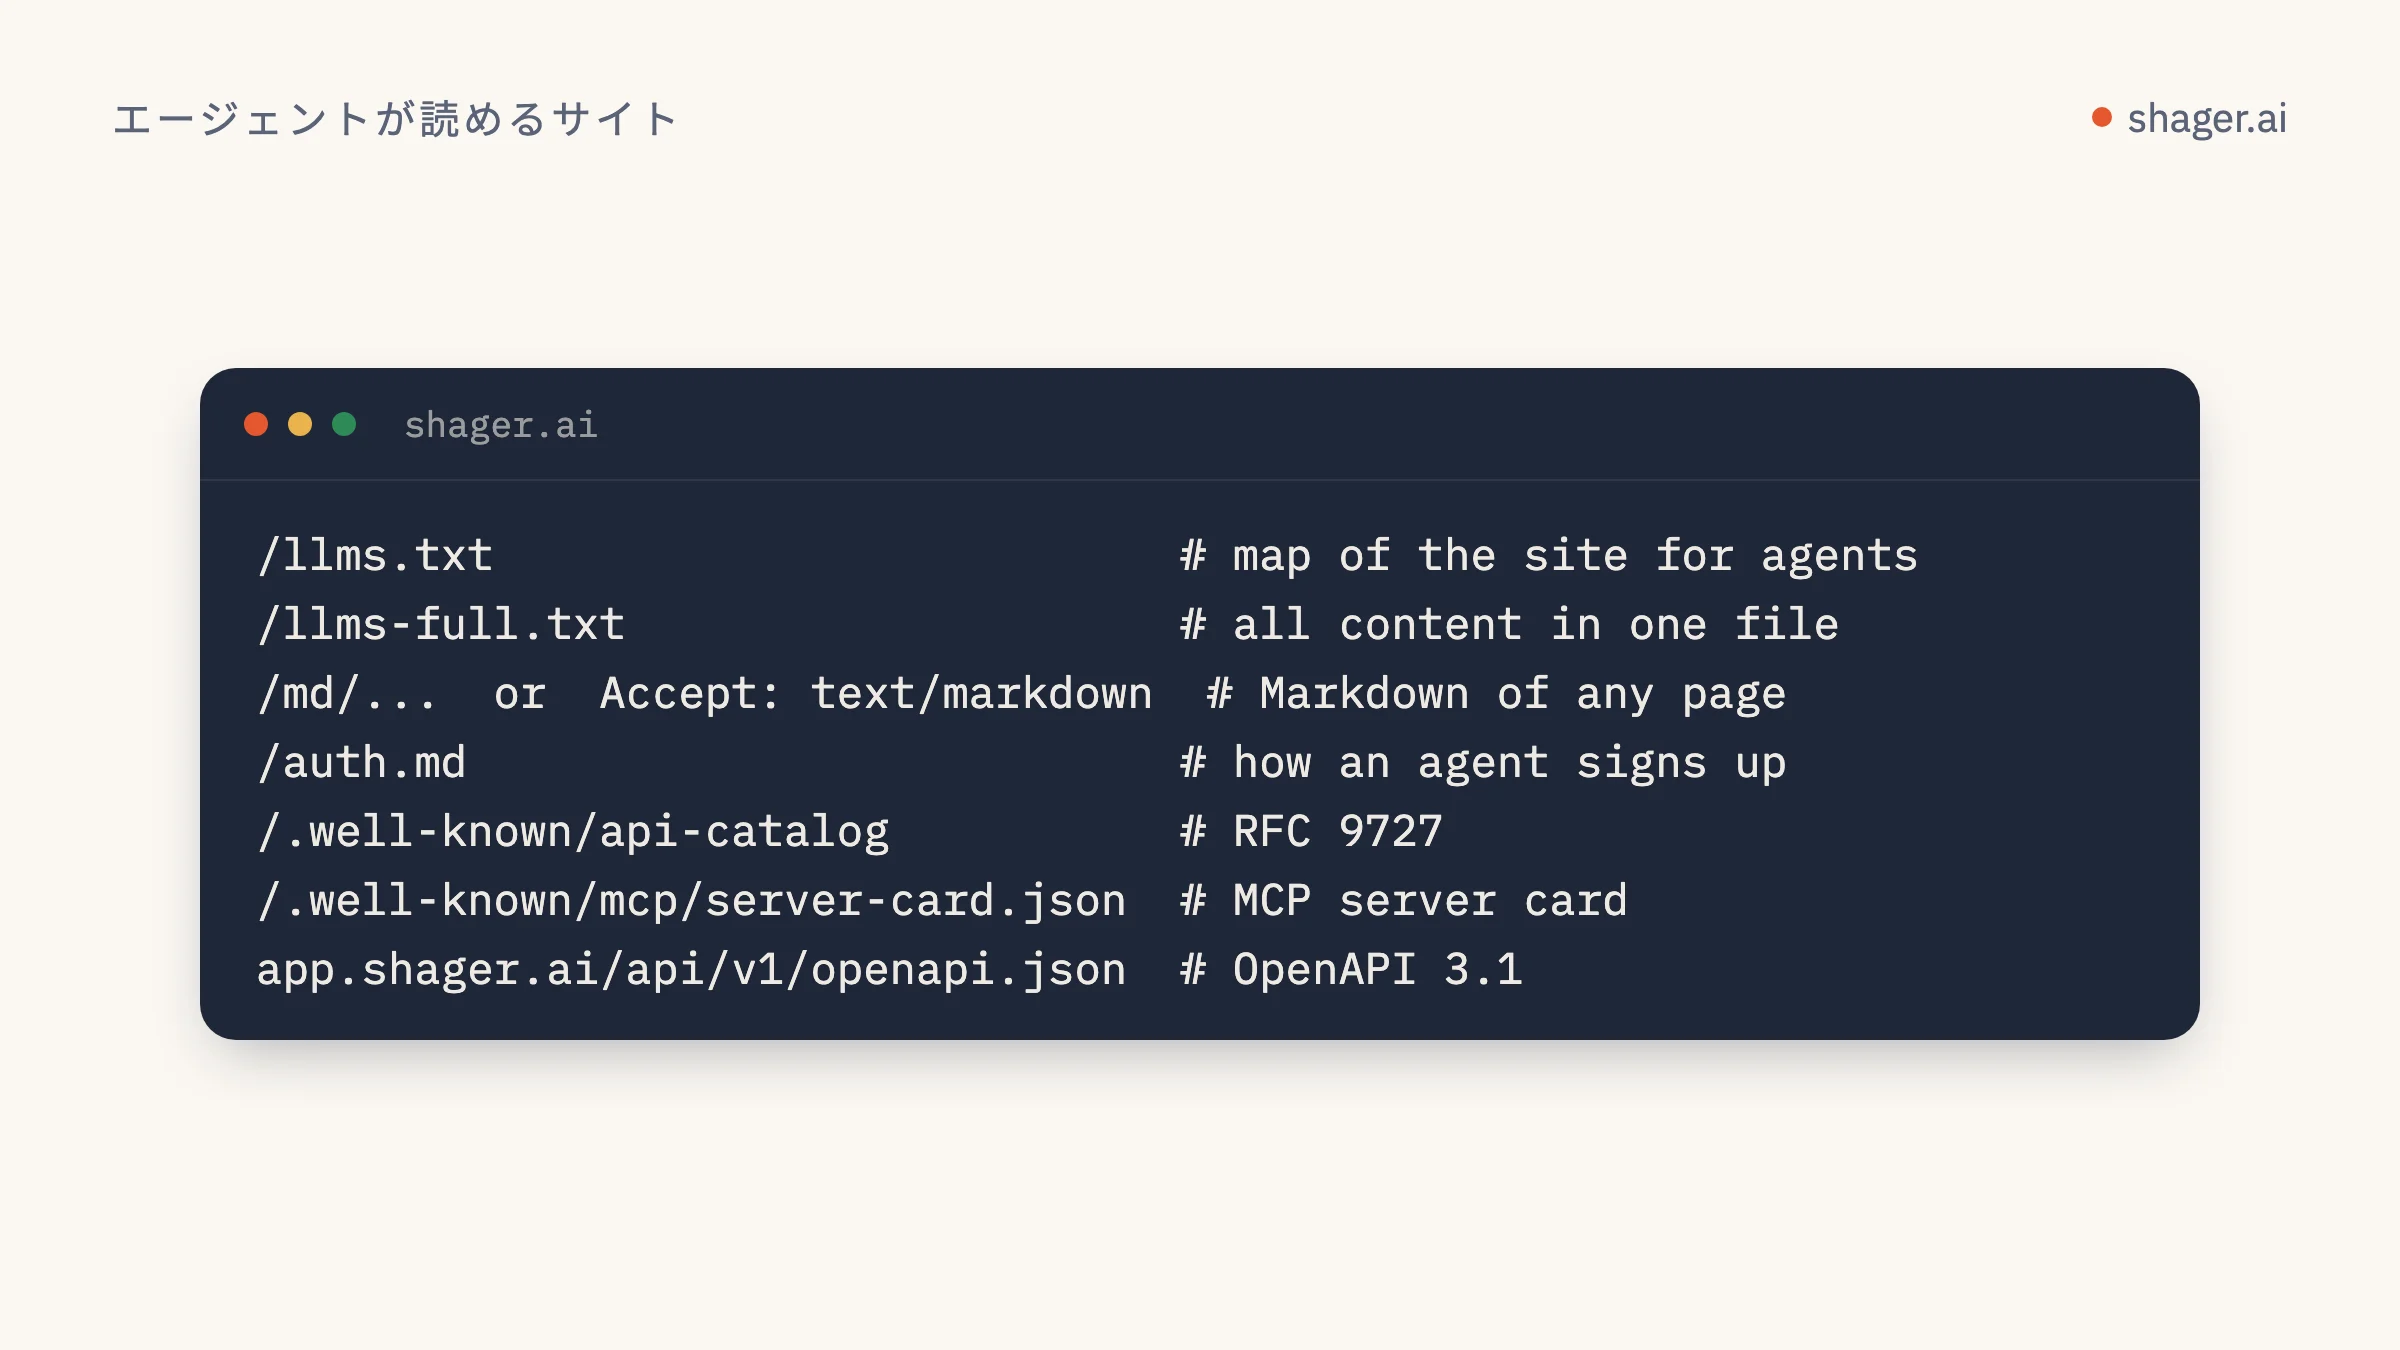
llms.txt:正面玄関
フォーマットは llmstxt.org で定義されています。/llms.txt に置く Markdown ファイルで、サイト名を示す H1(必須なのはここだけ)、引用ブロックによる概要、任意の本文、そして短い注記付きのリンク一覧を含む H2 セクションで構成されます。「Optional」というタイトルのセクションには、エージェントが短いコンテキストで済ませたいときに読み飛ばしてよいリンクを置きます。
Shager のファイルもこの形に沿っています。冒頭は次のとおりです。
# Shager

> Shager (שגר) is agent-first distribution infrastructure for agencies and
> marketers: your agent creates, Shager ships it everywhere. ...

## For AI agents
- MCP server: https://app.shager.ai/api/mcp (OAuth sign-in for any MCP client that supports it, or Authorization: Bearer <api key>)
- REST API: https://app.shager.ai/api/v1 ...
- Self sign-up: POST https://app.shager.ai/api/v1/agent/signup ...
参考にしてほしい工夫がいくつかあります。エージェント向けのセクションは、マーケティング用のページより前に置いています。このファイルを読むエージェントは、たいてい何かを実行したいからです。料金はリンク先ではなく、ファイルの中に具体的な数字で書いています。制限もはっきり書いています(たとえば、TikTok がアプリを承認するまで TikTok の投稿は非公開のままです)。そうすれば、エージェントがまだできないことをユーザーに約束してしまうことがありません。さらに、1回の取得で済ませたいエージェント向けに、全内容を1ファイルにまとめた /llms-full.txt も用意しています。
すべてのページの Markdown 版
同じ提案では、各ページのすっきりした Markdown 版を配信することも勧めています。その存在は rel="alternate" と type="text/markdown" で知らせ、さらにそのページを扱う llms.txt を rel="describedby" で指すのが推奨です。どちらも HTML の <link> 要素でも、HTTP の Link ヘッダーでも構いません。
Shager はこれを2つの方法で実現しています。すべてのページには /md/ 配下に Markdown 版があり、たとえば /en/pricing は /md/en/pricing でも読めます。また、通常の URL に Accept: text/markdown を付けてリクエストすると、Markdown がそのまま返ってきます。
curl -s -H "Accept: text/markdown" https://shager.ai/en/pricing | head -5
さらに、すべての HTML ページは代替版を知らせる Link ヘッダーを送ります。
link: </.well-known/api-catalog>; rel="api-catalog",
      </llms.txt>; rel="describedby"; type="text/plain",
      </md/en/agents>; rel="alternate"; type="text/markdown"
検索のうえで大事な点が1つあります。Markdown のレスポンスには x-robots-tag: noindex が付いているので、検索エンジンがすべてのページを2重にインデックスすることはありません。Markdown はエージェント向けで、人と検索結果にとっての正規ページはあくまで HTML です。
OpenAPI:契約書
エージェントが呼び出すものについては、今でも OpenAPI ドキュメントが公開できるもののなかでいちばん役に立ちます。オペレーション ID、パラメーター、スキーマ、認証方式を、エージェントとコード生成ツールの両方が読める形で伝えられるからです。
Shager の OpenAPI は app.shager.ai/api/v1/openapi.json にあり、バージョンは 3.1 です。特にエージェントの役に立つ決まりごとが3つあります。オペレーション ID は MCP のツール名(create_post、get_analytics)と一致しているので、片方のインターフェースを覚えたエージェントはもう片方もわかります。各オペレーションは、必要なキーのスコープを x-scope 拡張で宣言しています。そしてフィールドの説明は指示として書かれています。たとえば per_channel のキャプション上書きの説明には、アカウントごとに表現を変えることが推奨されると書いてあります。説明文はプロンプトの一部です。活用しましょう。
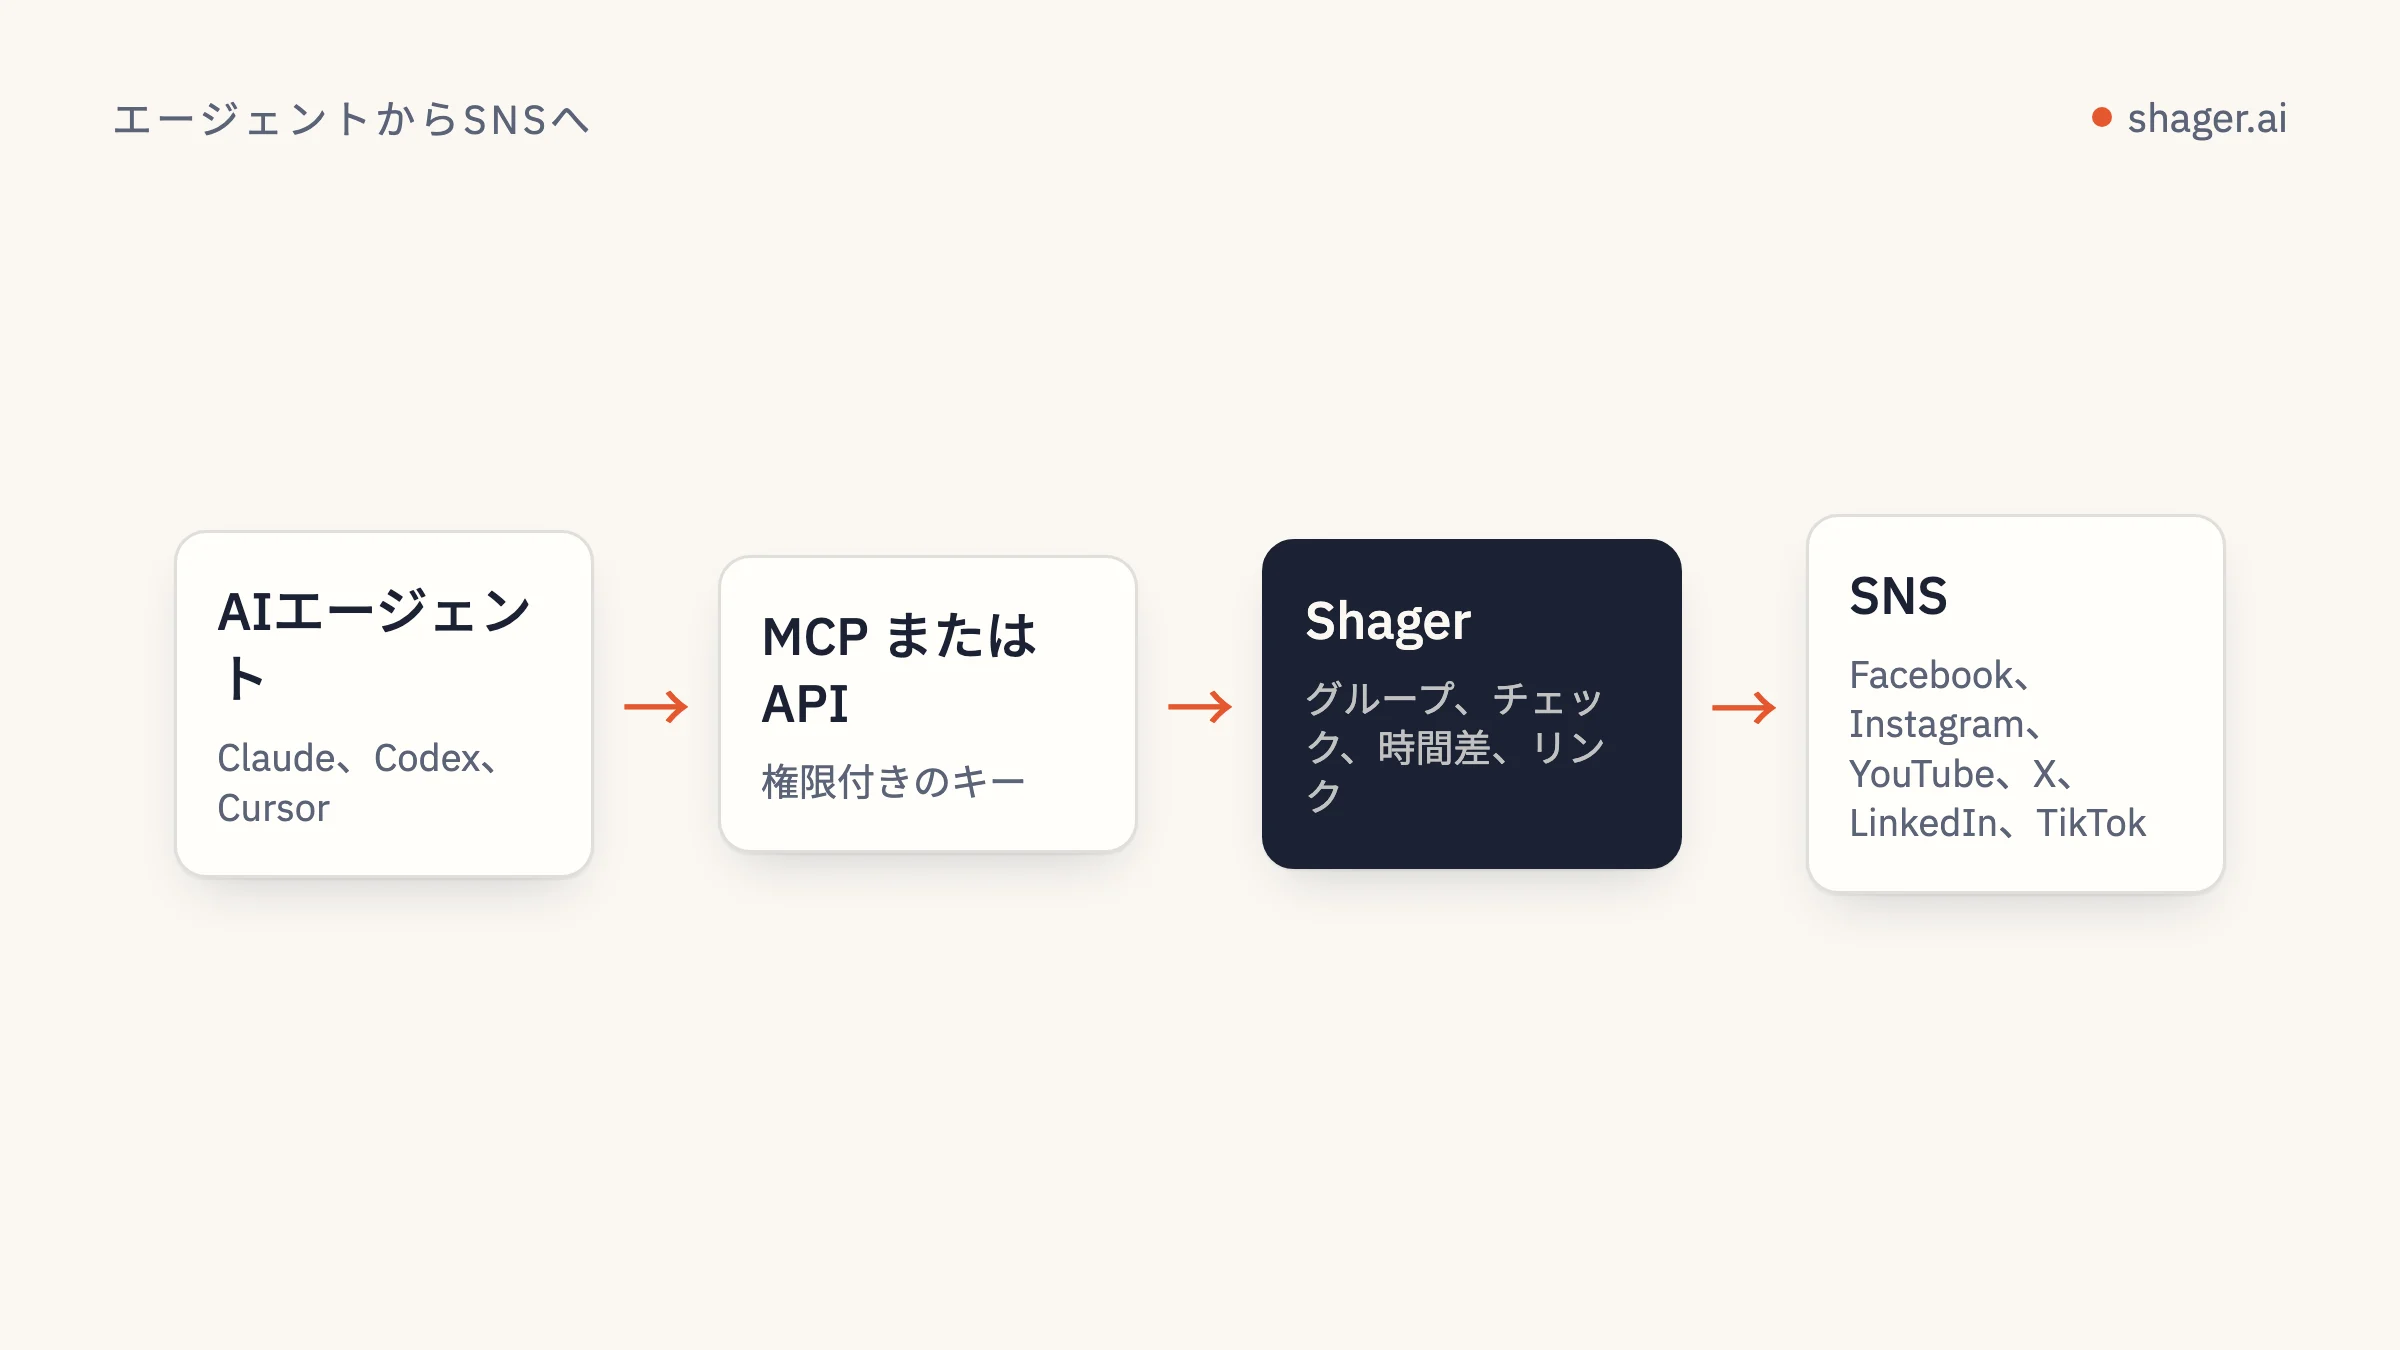
api-catalog:API の場所をソフトウェアに伝える
2025年6月に IETF が公開した RFC 9727 は、/.well-known/api-catalog という well-known URI と、api-catalog というリンクリレーションを定義しています。ここにリクエストすると、提供元の API の一覧が、それぞれの記述やドキュメントへのリンク付きで返ってきます。RFC はこのドキュメントのメディアタイプとして application/linkset+json を必須とし、OpenAPI のような機械可読の記述には service-desc、人向けのドキュメントには service-doc といったリンクリレーションを使います。
Shager のカタログの全文は次のとおりです。
{
  "linkset": [
    {
      "anchor": "https://app.shager.ai/api/v1",
      "service-desc": [
        { "href": "https://app.shager.ai/api/v1/openapi.json", "type": "application/openapi+json" }
      ],
      "service-doc": [
        { "href": "https://shager.ai/en/agents", "type": "text/html" },
        { "href": "https://shager.ai/md/en/agents", "type": "text/markdown" }
      ]
    }
  ]
}
短いのは、Shager の API が1つだからです。複数の API を持つ企業なら、API ごとに1件ずつ並べます。先ほど示したとおり、すべてのページの Link ヘッダーには rel="api-catalog" のリンクが入っています。どのページにたどり着いたクライアントも、パスを推測せずにカタログを見つけられるのはこのためです。
MCP サーバーカード:接続する前に接続方法を知る
MCP クライアントが tools/list を呼ぶには、その前にサーバーの場所と認証方法を知っておく必要があります。SEP-2127 は、まさにそのための MCP Server Cards を定義しています。リモートサーバーの識別情報、トランスポートのエンドポイント、必須ヘッダー、対応するプロトコルバージョンを記述した静的な JSON ドキュメントです。SEP は推奨の置き場所として <streamable-http-url>/server-card を予約し、カードへのリンクを持つ AI Catalog によるドメイン単位の発見方法も示しています。詳細なスキーマは拡張のリポジトリにあります。
Shager はカードを推奨の場所である https://app.shager.ai/api/mcp/server-card で配信しているほか、一部の発見ツールが確認しにいく https://shager.ai/.well-known/mcp/server-card.json にも置いています。接続に関する部分は次のとおりです。
{
  "name": "ai.shager/shager",
  "title": "Shager",
  "version": "1.0.0",
  "remotes": [
    {
      "type": "streamable-http",
      "url": "https://app.shager.ai/api/mcp",
      "headers": [
        { "name": "Authorization", "isRequired": true, "isSecret": true,
          "description": "Bearer shgr_… API key (self-signup: POST /api/v1/agent/signup)" }
      ]
    }
  ]
}
カードには、Shager のツールの一覧も1行の説明付きで載せています。ただし SEP は、ツールをあえて標準のカードのフィールドに含めていません。サーバーが公開するものは、ユーザーやセッションによって変わりうるからです。カードにあるツール一覧はあくまでプレビューとして扱い、正となるのはその場で呼ぶ tools/list の結果です。
おまけの2つ:auth.md とスキルファイル
発見の仕組みは、何があるかをエージェントに伝えます。さらに2つのファイルが、何をすべきかを伝えます。
/auth.md は、エージェントがアクセスを得るまでの手順をそのまま書いたレシピです。発見し、セルフサインアップの呼び出しで登録し、キーを使い、引き継ぎ用のリンクを人に渡す。そして人がアクセスを取り消す方法まで書いてあります。レート制限、エラーの形式、キャプションのバリエーション、公式 API のみを使うこと、といったルールも明記しています。エージェントは上から順に従えば済みます。
https://shager.ai/skills/shager/SKILL.md は、Claude Code のスキルで使われる形式のスキルファイルです。name と、どんなときに使うかをモデルに伝える description を含む YAML フロントマターのあとに、番号付きの手順が続きます。これをインストールすれば、長いプロンプトなしでエージェントが Shager の作業の流れを把握できます。自分用に作る方法は、Shager 用の Claude スキルを作るで解説しています。
自社サイト向けチェックリスト
- H1、1段落の概要、先頭にエージェント向けセクションがあり、まだ公開されていないものには正直にそう書いた
/llms.txt。 - 各ページの Markdown 版。
rel="alternate"とtype="text/markdown"で知らせ、noindexを付ける。 - MCP ツールと一致するオペレーション ID を持ち、説明を指示として書いた OpenAPI ドキュメント。
application/linkset+jsonで返す/.well-known/api-catalog。すべてのページからrel="api-catalog"でリンクする。<your MCP URL>/server-cardに置いた MCP サーバーカード。- エージェントが登録できるなら、
auth.mdのような平易な言葉で書いたアクセス手順。
よくある質問
llms.txt は robots.txt と同じものですか?
違います。robots.txt は、クローラーが何を取得してよいかを伝えるものです。llms.txt は、読む価値のあるものを厳選した、言語モデル向けのガイドです。何かを許可したり禁止したりするものではありません。
これらのファイルを公開すると、検索順位は上がりますか?
上がるという公開された根拠はなく、llms.txt をランキングの指標に使っていると表明した検索エンジンもありません。価値があるのは、エージェントが訪れたときにプロダクトを正しく使ってもらえる点です。検索については、HTML ページそのものの質で勝負してください。
恩恵を受けるには MCP サーバーが必要ですか?
必要ありません。llms.txt、Markdown 版ページ、OpenAPI、api-catalog は、ドキュメントや API を持つあらゆるサイトで役に立ちます。サーバーカードが関係するのは、リモートの MCP サーバーを運用している場合だけです。
次に読むもの
Shager のファイルを curl で取得し、自社サイトと比べてみてください。発見したあとにエージェントが何をするかは、エージェント向けの入口をご覧ください。